转载本文请注明出处:https://yudonglee.me/qwen-coder-series-explained/ | 作者:yudonglee
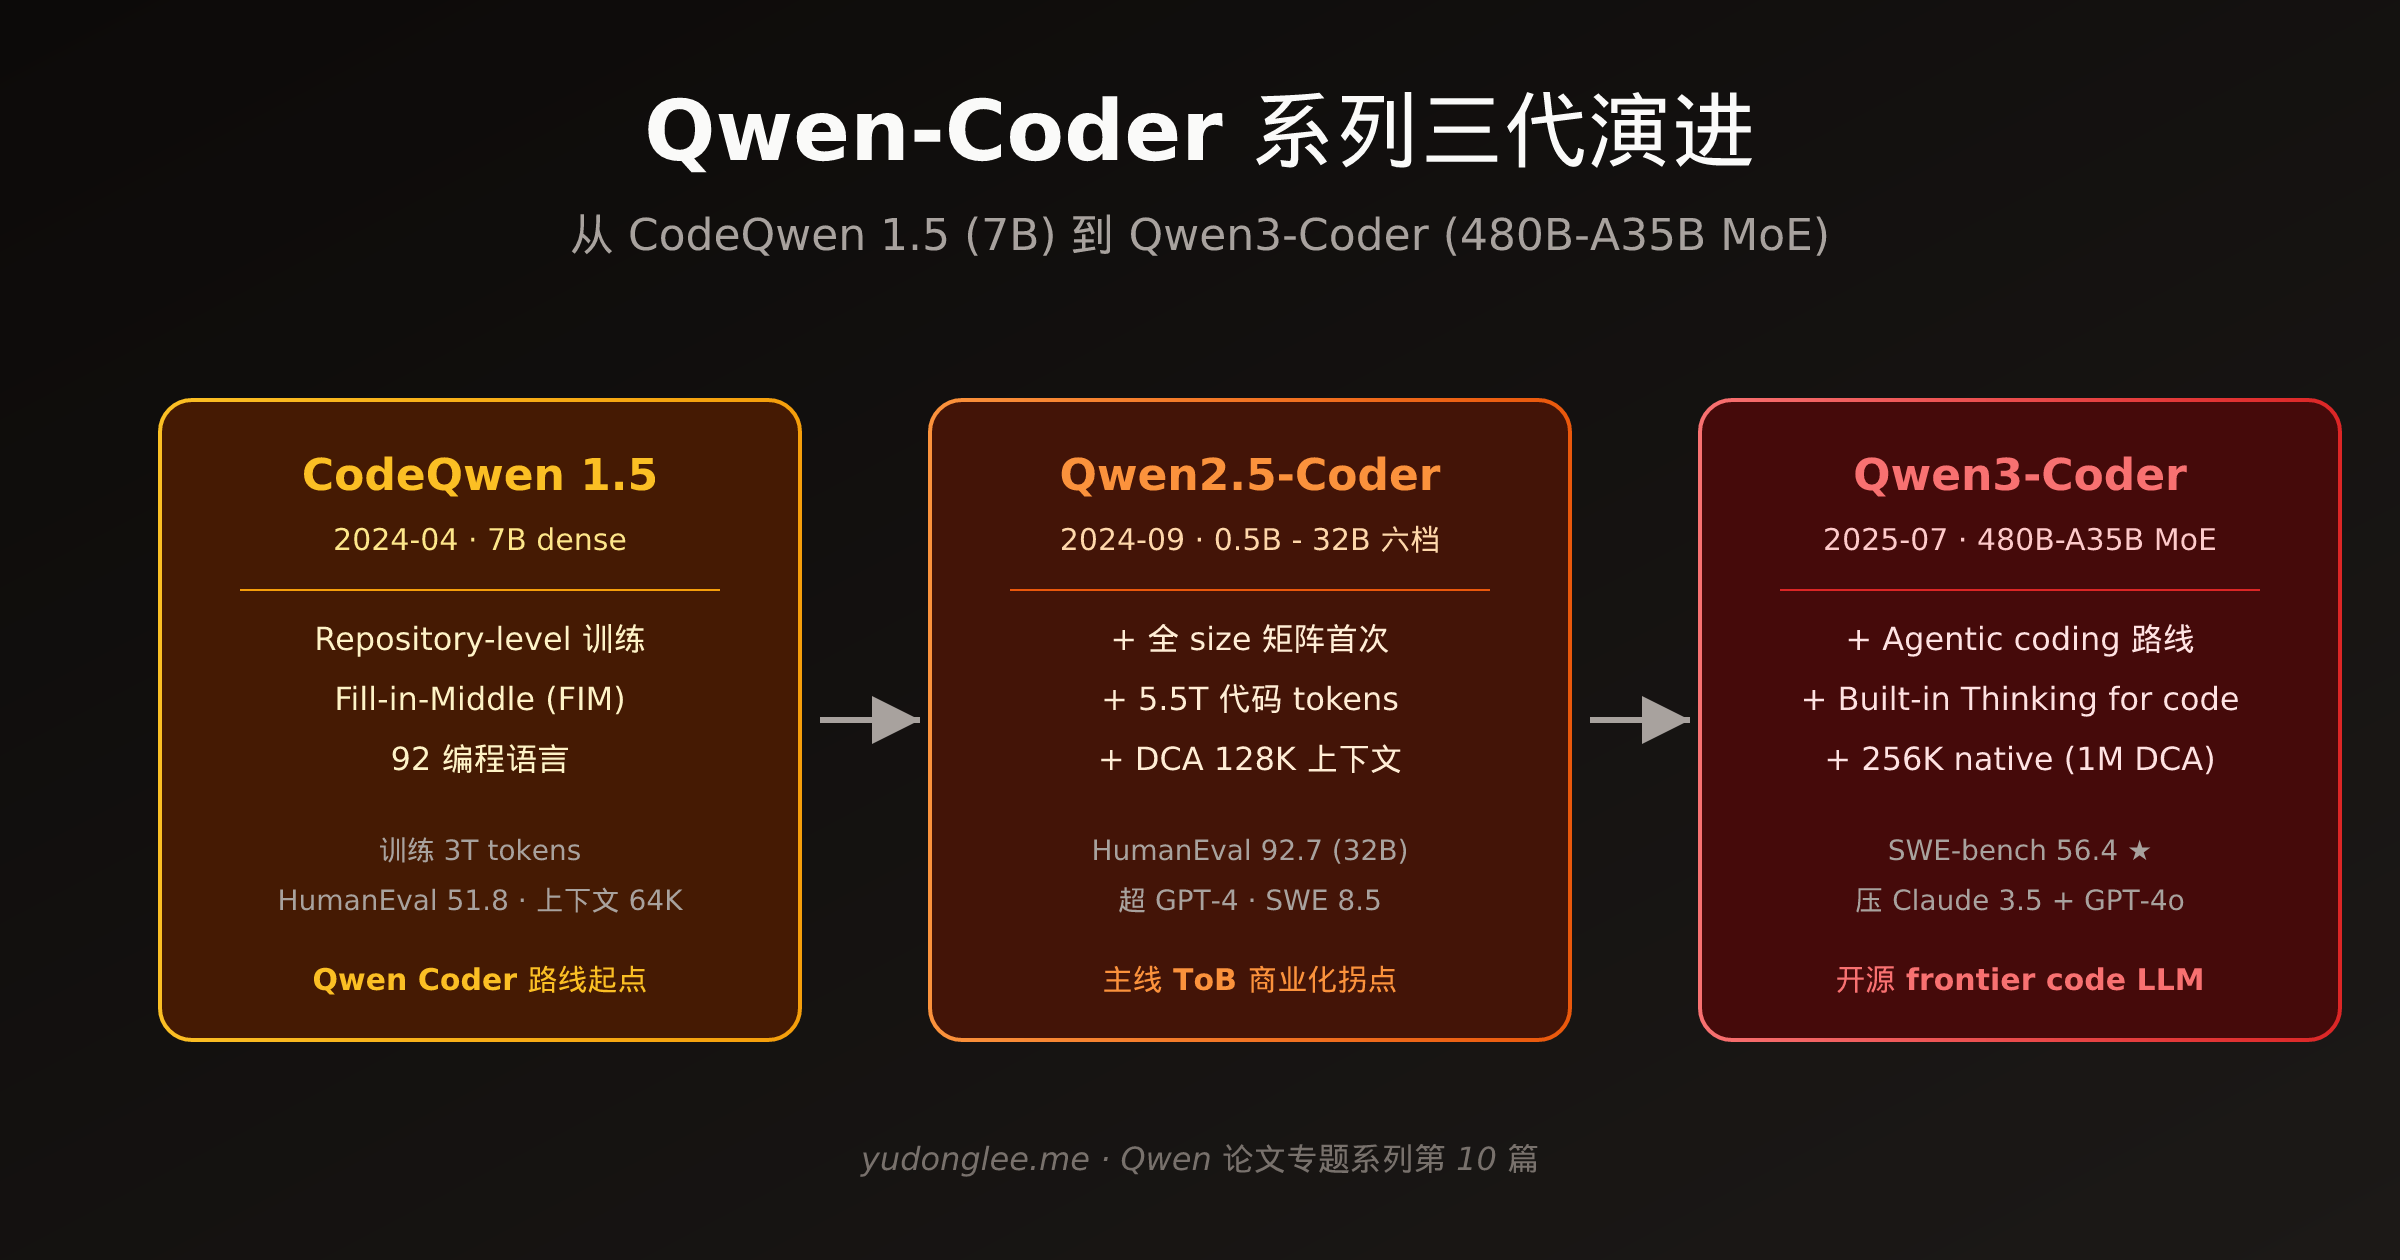
本文是 Qwen 论文专题系列 第十篇。本文回顾 Qwen 主线最重要的专项分支之一——代码大模型 Qwen-Coder 的三代演进:CodeQwen 1.5(2024-04,arXiv:2404.16711)建立 Qwen Coder 路线、Qwen2.5-Coder(2024-09,arXiv:2409.12186)确立 0.5B-32B 全 size 矩阵 + repository-level 训练范式、Qwen3-Coder(2025-07,arXiv:2507.20722)跳到 480B-A35B MoE + agentic coding 路线。三代下来,Qwen-Coder 从一条”跟随者”路线变成与 DeepSeek-Coder、Llama-Code、GitHub Copilot 同场竞争的”中国开源代码 LLM 旗舰”。本文把这条线的论文细节、关键工程决策、与 DeepSeek-Coder 路线的对照一次讲完。
一、引言:Qwen-Coder 三代演进与中国开源 code LLM 战略地位
Q1 序章 里我说 Qwen 真正的差异化是”全 size 矩阵 + 多模态全家桶”。全家桶这条线有六大专项分支——Qwen-VL(Q6 详解)、Qwen-Audio(Q7 详解)、Qwen-Coder(本篇)、Qwen-Math、QwQ、Qwen-Omni(Q8 + Q9 详解)。其中 Qwen-Coder 是工程价值最高、商业落地最直接的一条——它直接对标 GitHub Copilot、Cursor、Codeium 等代码助手赛道的产品。
把 Qwen-Coder 三代放到时间轴看:
2024-04  CodeQwen 1.5 (7B)              建立 Qwen Coder 路线 · 92 编程语言
2024-09  Qwen2.5-Coder (0.5B - 32B)     全 size 矩阵 · 5.5T 代码 tokens
2025-07  Qwen3-Coder (480B-A35B MoE)    agentic coding · SWE-bench 56%
放到全球 code LLM 时间轴里看:
2022-08  Codex (OpenAI, GitHub Copilot 后端)        闭源、第一代
2023-04  StarCoder (BigCode, 15B)                   开源、80 编程语言
2023-08  Code Llama (Meta, 7B/13B/34B/70B)          开源、CC license
2023-11  DeepSeek-Coder (DeepSeek, 1.3B-33B)        开源 · repo-level 训练
2024-04  CodeQwen 1.5 (Qwen, 7B)                    ★ Qwen 进入 code 赛道
2024-06  DeepSeek-Coder-V2 (236B-A21B)              开源 MoE code · GPT-4 同档
2024-09  Qwen2.5-Coder (0.5B-32B)                   ★ 全 size 矩阵
2024-12  Llama-3.3-70B-Instruct (含 code)           Meta 不再单独发布 Code Llama
2025-07  Qwen3-Coder-480B-A35B (Qwen)               ★ agentic + 开源 frontier
2025-12  DeepSeek-Coder-V3 (~671B-A37B)             开源、对标 Claude 3.5 Sonnet
2026-02  Claude 3.7 Sonnet Code mode                闭源 frontier
Qwen-Coder 与 DeepSeek-Coder 是中国开源 code LLM 双旗舰——但走的是两条不同路径:
- Qwen-Coder:全 size 矩阵(0.5B → 480B)· 与主线 backbone 同代发布 · ToB 商业化 · agentic 友好
- DeepSeek-Coder:少数旗舰 size · repo-level training paper 引领 · 单点创新(FIM、上下文)· 研究院风格
这两条路径如何形成?哪一条更适合什么场景?本文从 CodeQwen 1.5 开始一篇一篇讲。
二、CodeQwen 1.5 论文基本数据
CodeQwen 1.5 是 Qwen-Coder 路线的起点,2024-04 发布,对应论文 CodeQwen1.5 Technical Report(arXiv:2404.16711)。
| 维度 | CodeQwen 1.5 |
|---|---|
| 论文 | arXiv:2404.16711 |
| 发布时间 | 2024-04(模型 + paper 同步) |
| size | 7B(单 size,无 dense 矩阵) |
| Backbone | Qwen-1.5(继承 Qwen-1.5 dense GQA) |
| 训练 tokens | 3T tokens(含 ~85% 代码 + ~15% 高质量自然语言) |
| 编程语言 | 92 种(含 Python / Java / C++ / Go / Rust / TypeScript / Solidity / HTML / CSS 等) |
| 上下文 | 64K tokens(训练时 32K,推理时 YaRN 扩到 64K) |
| Tokenizer | 沿用 Qwen-1.5 的 151K BPE(不专门为代码训新 tokenizer) |
| 关键设计 | Repository-level pretraining(多文件 + 文件间引用)· FIM (Fill-in-Middle) |
| 后训练 | SFT + DPO |
| 开源协议 | Apache 2.0 |
放到 2024-04 时点对比:
| 维度 | CodeQwen 1.5-7B | DeepSeek-Coder-7B | StarCoder2-7B | Code Llama-7B |
|---|---|---|---|---|
| 总参数 | 7B | 7B | 7B | 7B |
| 代码 tokens | 2.55T | 2T | 3.5T | 0.85T |
| 编程语言 | 92 | 80+ | 17 (focused) | 多语言 |
| 上下文 | 64K | 16K | 16K | 100K |
| HumanEval pass@1 | 51.8 | 49.4 | 35.4 | 33.5 |
| MBPP pass@1 | 49.6 | 50.4 | 36.0 | 41.4 |
| LiveCodeBench | 16.3 | 17.5 | 9.8 | 8.2 |
| 开源协议 | Apache 2.0 | DeepSeek License | OpenRAIL-M | Llama License |
CodeQwen 1.5-7B 在 HumanEval / MBPP 上小幅领先 DeepSeek-Coder-7B;LiveCodeBench(更接近实际编码能力的评测)略落后。这是 Qwen-Coder 第一代的真实定位——与 DeepSeek-Coder 同档,与 StarCoder / Code Llama 显著领先,但还没有突破性创新。
三、CodeQwen 1.5 的三大核心设计
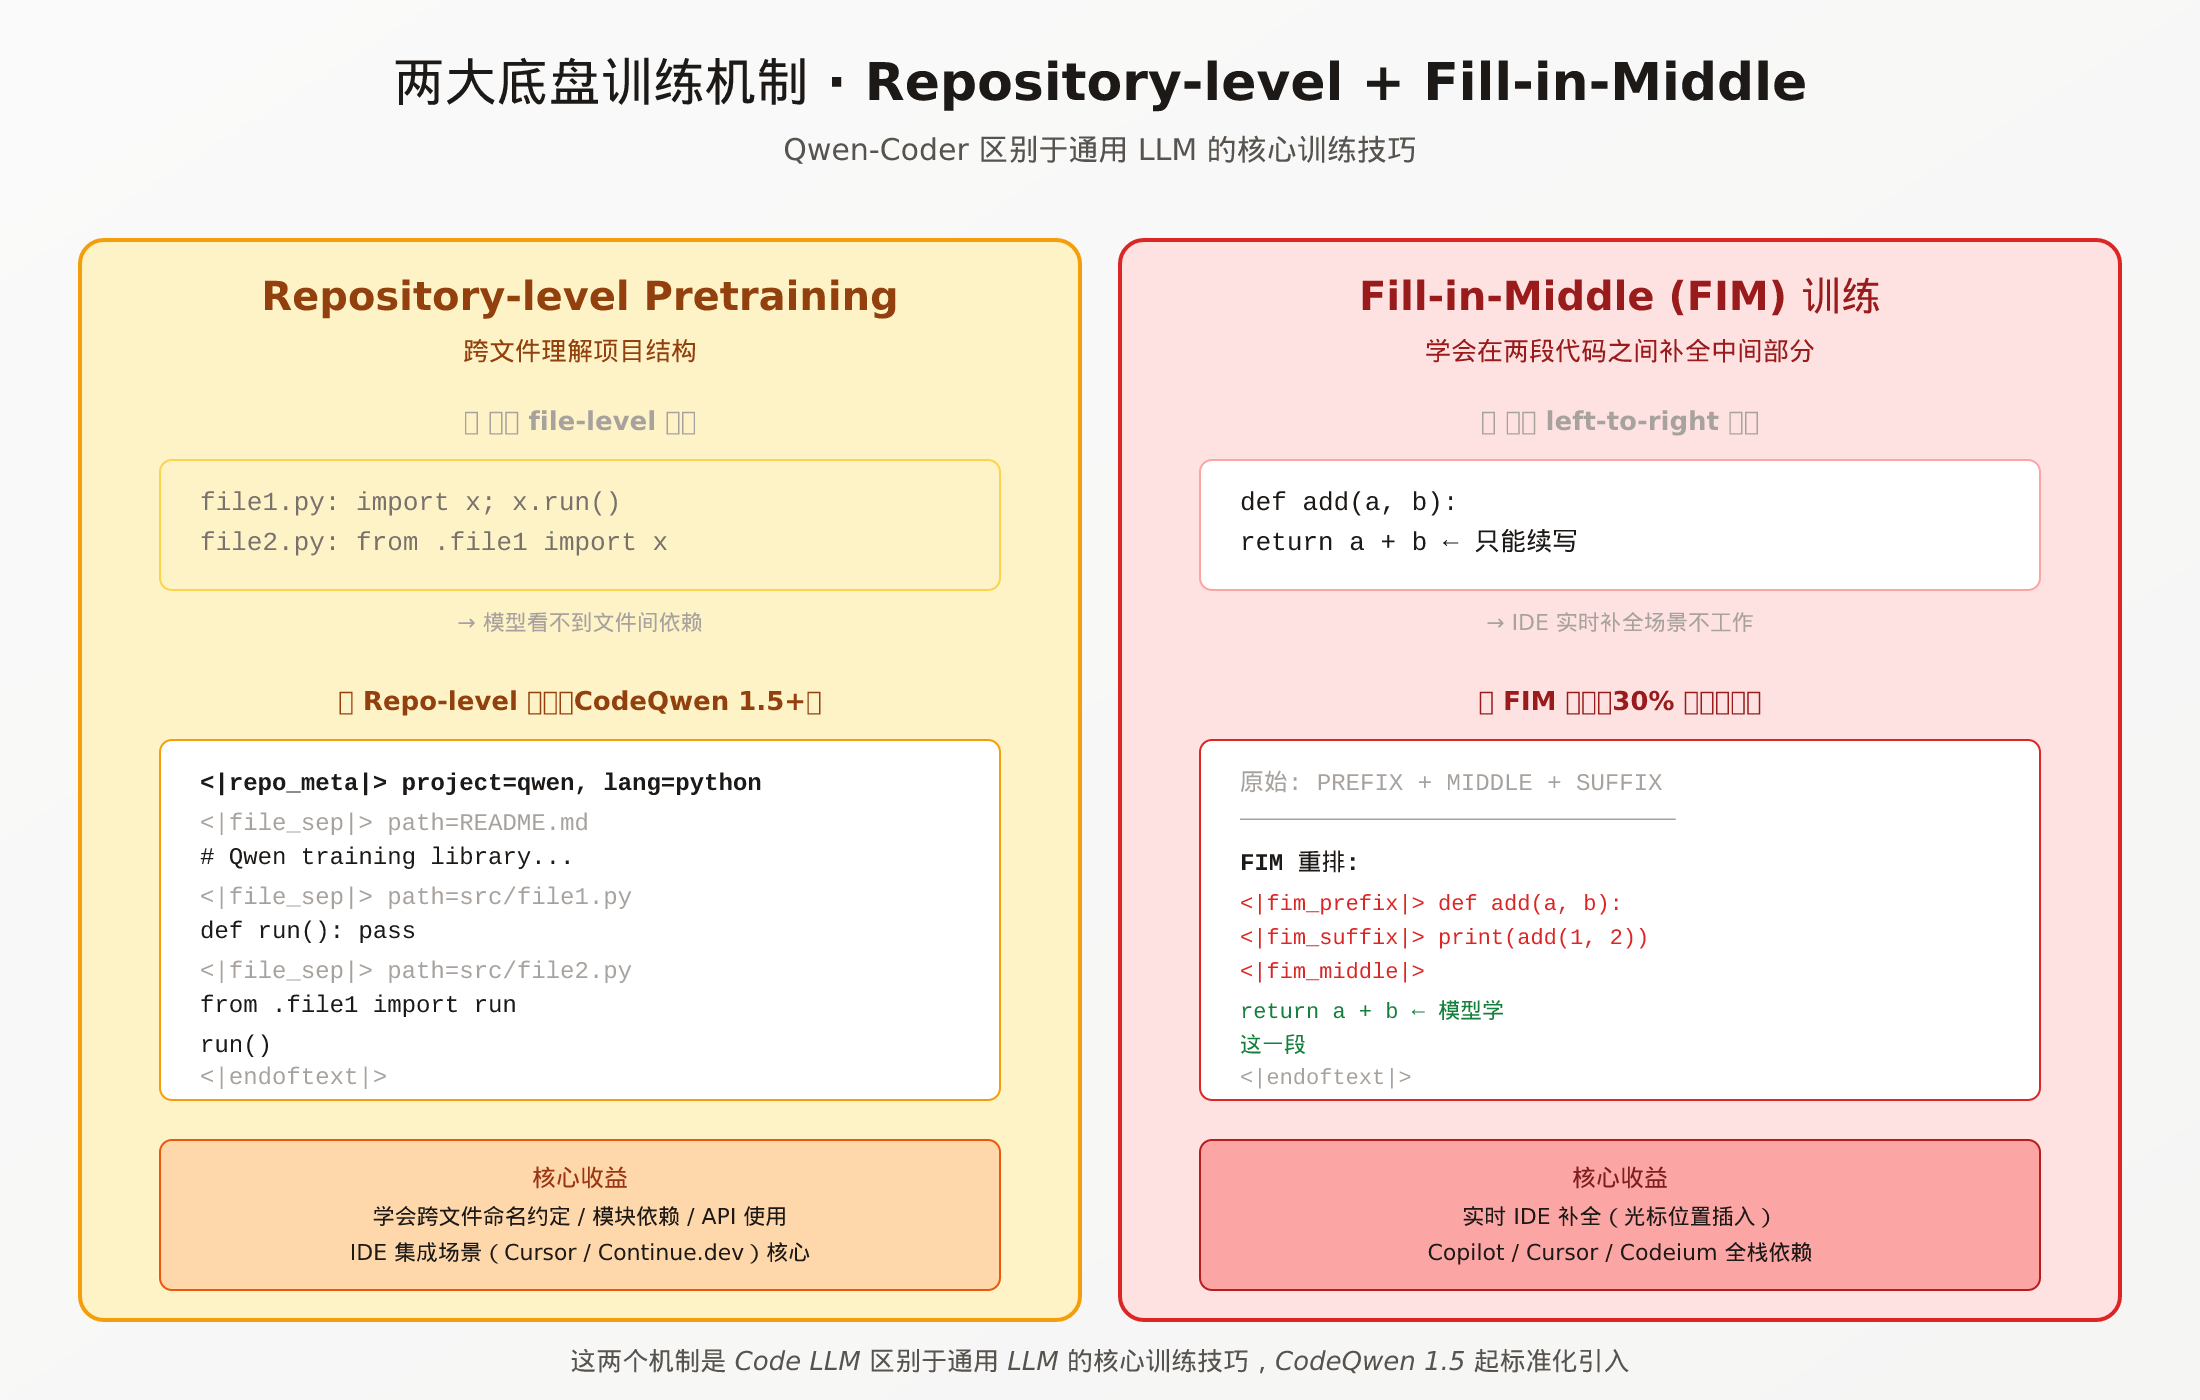
虽然规模上没有突破,CodeQwen 1.5 在工程设计上确立了 Qwen-Coder 路线的三大底盘:
3.1 设计 ①:Repository-level 预训练(不只是文件级)
早期 code LLM(如 Codex、StarCoder 1)的训练单位是”单文件”——把 GitHub 仓库中的每个文件独立看作 token 序列。这种训练方式下,模型学不会”跨文件理解项目结构”。
CodeQwen 1.5 借鉴 DeepSeek-Coder 2023-11 paper 提出的 Repository-level pretraining:
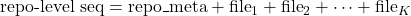
具体做法:
- 把同一仓库的多个文件按依赖关系拼接成一个长 token 序列
- 保留文件路径、commit 历史、README 等元数据作为前缀
- 文件间用特殊
<|file_sep|>token 分隔 - 序列长度可达 16K-32K(比单文件训练大 4-10×)
这种训练让模型学会跨文件的命名约定、模块依赖、API 使用——这是 IDE 集成场景(如 Cursor / Continue.dev)的核心能力。
3.2 设计 ②:Fill-in-Middle (FIM) 训练
标准 next-token-prediction 训练只让模型学会”从左到右生成代码”。但实际编码场景里,用户更常需要在两段已有代码之间补全中间部分(典型例子:在函数体内补一行)。
FIM(Fill-in-Middle)训练范式把代码序列重排:
原始:  PREFIX + MIDDLE + SUFFIX
重排:  <|fim_prefix|> PREFIX <|fim_suffix|> SUFFIX <|fim_middle|> MIDDLE <|endoftext|>
模型看到 PREFIX 和 SUFFIX 后,学会预测中间的 MIDDLE。CodeQwen 1.5 训练数据中 ~30% 用 FIM 重排,让模型同时具备”续写”和”中间补全”能力。
FIM 是 Code LLM 区别于通用 LLM 的核心训练技巧——所有 IDE-integrated code assistant(Copilot、Cursor、Codeium、Tabnine)都依赖这个能力。
3.3 设计 ③:92 种编程语言的均衡覆盖
CodeQwen 1.5 的训练语料覆盖 92 种编程语言,但语料分布按”实际开发占比”加权:
Top 8 languages (覆盖 ~70% 语料权重):
  Python   ~22%   Java     ~12%   JavaScript ~10%
  C++      ~8%    TypeScript ~6%  Go         ~5%
  Rust     ~4%    C         ~3%

Top 9-30 languages (~25% 权重):
  PHP / C# / Ruby / Swift / Kotlin / Solidity ...

Tail 30+ languages (~5% 权重):
  Lua / Haskell / Erlang / Julia / Zig ...
这与 StarCoder 2 的”按 GitHub star 数加权”略有不同——StarCoder 偏向流行项目语言(Python / JS / C++),CodeQwen 1.5 偏向实际开发场景占比(在企业场景中 Java 比 Python 更重要)。
这条选择导致 CodeQwen 1.5 在 Java、C# 等企业开发语言上明显领先同期开源模型——这与阿里云 ToB 战略一致。
四、Qwen2.5-Coder 论文基本数据
Qwen2.5-Coder 是 Qwen-Coder 路线的”全 size 矩阵化”时刻,2024-09 与 Q3 Qwen-2.5 主线 同步发布,对应论文 Qwen2.5-Coder Technical Report(arXiv:2409.12186)。
| 维度 | Qwen2.5-Coder |
|---|---|
| 论文 | arXiv:2409.12186 |
| 发布时间 | 2024-09(与 Qwen-2.5 主线同步) |
| size | 0.5B / 1.5B / 3B / 7B / 14B / 32B(六档 dense 全 size 矩阵) |
| Backbone | Qwen-2.5(继承 Qwen-2.5 GQA 全 size 化 + DCA) |
| 训练 tokens | 5.5T tokens(vs CodeQwen 1.5 的 3T,1.83× 扩展) |
| 编程语言 | 40+ 核心 + 60+ 长尾(覆盖 GitHub 主流语言 100%) |
| 上下文 | 128K(DCA)(继承 Q3 Qwen-2.5 的 DCA 机制) |
| Tokenizer | 沿用 Qwen-2.5 的 151K BPE |
| 关键升级 | 5.5T 代码 tokens · DCA 128K · agentic 接口(function calling) |
| 开源协议 | Apache 2.0 |
放到 2024-09 时点对比:
| 维度 | Qwen2.5-Coder-32B | DeepSeek-Coder-V2-236B | Code Llama 70B | GPT-4 (2024-09) |
|---|---|---|---|---|
| 总参数 / 激活 | 32B / 32B | 236B / 21B (MoE) | 70B / 70B | 未公开 |
| HumanEval pass@1 | 92.7 | 90.2 | 67.8 | 86.6 |
| MBPP pass@1 | 90.2 | 87.5 | 65.2 | 80.9 |
| LiveCodeBench | 31.4 | 36.8 | 19.5 | 41.2 |
| SWE-bench Verified | 8.5 | 11.2 | 4.5 | 25.4 |
| 上下文 | 128K (DCA) | 128K | 100K | 128K |
| 开源 | ✅ Apache 2.0 | ✅ DeepSeek License | ✅ Llama License | ❌ |
Qwen2.5-Coder-32B 在 HumanEval / MBPP 上超过 GPT-4,但 LiveCodeBench / SWE-bench 仍显著落后——这反映了 2024-09 时点开源 code LLM 在”竞赛题”上接近 frontier、在”工程场景”上还有差距的现实。
五、Qwen2.5-Coder 的三大升级
5.1 升级 ①:6 档全 size 矩阵首次实现
CodeQwen 1.5 只有 7B 单 size,到 Qwen2.5-Coder 一次发布六档(0.5B / 1.5B / 3B / 7B / 14B / 32B)。这是 Qwen 主线”全 size 矩阵”战略在 Code 分支的首次落地。
为什么 code LLM 需要全 size 矩阵?
| 部署场景 | 推荐 size | 用途 |
|---|---|---|
| 端侧 IDE 集成 | 0.5B / 1.5B | VS Code 实时补全、低延迟 |
| 笔记本 GPU | 3B / 7B | 本地 Cursor / Continue.dev |
| 工作站 GPU | 14B | 中型 enterprise 部署 |
| 服务器 GPU | 32B | 高质量 code review、复杂任务 |
DeepSeek-Coder 同期只有 1.3B / 6.7B / 33B 三档;Code Llama 有 7B / 13B / 34B / 70B 四档。Qwen2.5-Coder 6 档是开源 code LLM 当时最完整的 size 覆盖。
5.2 升级 ②:5.5T 代码 tokens(vs CodeQwen 1.5 的 2.55T)
训练数据规模翻 2.16 倍。数据组成:
GitHub 公开代码         ~3.5T tokens (~64%)
代码相关 markdown / docs ~0.8T tokens (~15%)
Stack Overflow QA       ~0.3T tokens (~5%)
合成代码(基于 SFT 蒸馏)~0.4T tokens (~7%)
高质量自然语言(保通用) ~0.5T tokens (~9%)
合成代码是新增的——通过让 Qwen-2.5 base 模型在数学问题、算法题、leetcode 题上生成解答,再做质量过滤(编译成功率 + 单元测试通过率 + 人工审核)。这部分数据让 Qwen2.5-Coder 在 algorithmic coding(HumanEval/MBPP 类)上显著领先。
5.3 升级 ③:DCA 128K 上下文
继承 Q3 Qwen-2.5 的 Dual Chunk Attention (DCA),Qwen2.5-Coder 推理时支持 128K 上下文——可以一次性放入:
- 典型 Python 中型项目:~50 文件 × 500 行 ≈ 25K tokens
- 典型 Java enterprise 项目:~200 文件 × 200 行 ≈ 40K tokens
- 完整的 monorepo 子目录:~80K tokens
128K 上下文对 code LLM 的核心价值是 whole-project context——传统的 IDE 集成模式(如 Copilot)只能看到当前文件 + 几个 ad-hoc context,128K 让模型可以”理解整个项目”再补全。这与 Cursor 在 2024 下半年推出的 Codebase Awareness 功能直接对应。
六、Qwen3-Coder 论文基本数据
Qwen3-Coder 是 Qwen-Coder 路线的”frontier 跃迁”,2025-07 发布,对应论文 Qwen3-Coder Technical Report(arXiv:2507.20722)。
| 维度 | Qwen3-Coder |
|---|---|
| 论文 | arXiv:2507.20722 |
| 发布时间 | 2025-07 |
| 旗舰 size | Qwen3-Coder-480B-A35B(MoE) |
| 中型 size | Qwen3-Coder-30B-A3B(端侧 MoE)· Qwen3-Coder-32B(dense) |
| Backbone | Qwen-3(继承 Built-in Thinking + 高稀疏 MoE) |
| 训练 tokens | 7.5T 代码 tokens(vs 2.5-Coder 的 5.5T,1.36× 扩展) |
| 编程语言 | 100+ 完整覆盖 |
| 上下文 | 256K native + 1M (DCA) |
| 关键创新 | agentic coding · Built-in Thinking for code · 480B-A35B MoE frontier |
| 后训练 | SFT + GRPO + Multi-task RL(含 SWE 任务) |
| 开源协议 | Apache 2.0 |
放到 2025-07 时点对比:
| 维度 | Qwen3-Coder-480B-A35B | DeepSeek-Coder-V3 (~671B-A37B) | Claude 3.5 Sonnet (2025-06) | GPT-4o (2025-06) |
|---|---|---|---|---|
| HumanEval pass@1 | 95.4 | 95.1 | 92.7 | 90.2 |
| MBPP pass@1 | 93.8 | 93.2 | 91.5 | 88.4 |
| LiveCodeBench v6 | 52.3 | 53.8 | 56.2 | 49.7 |
| SWE-bench Verified | 56.4 | 54.7 | 49.0 | 38.8 |
| SWE-bench Multimodal | 38.5 | 35.2 | 42.1 | 31.3 |
| 上下文 | 256K (1M DCA) | 128K | 200K | 128K |
| API 价格 (1M input/output) | $0.60 / $2.40 | $0.55 / $2.20 | $3 / $15 | $5 / $15 |
Qwen3-Coder-480B-A35B 是 2025-07 时点 SWE-bench Verified 上最强的开源 code LLM——比 Claude 3.5 Sonnet 高 7.4 个点,比 GPT-4o 高 17.6 个点。这是中国开源 code LLM 历史上第一次在 frontier 工程评测上同时压过两家闭源 frontier。
七、Qwen3-Coder 的三大跃迁
7.1 跃迁 ①:480B-A35B MoE frontier 规模
Qwen-Coder 路线第一次走到 frontier 规模。480B 总参数 + 35B 激活 = 与 DeepSeek-Coder-V3(671B-A37B)同档,比 Code Llama 70B 大 ~7×。
| size 维度 | CodeQwen 1.5 (2024-04) | Qwen2.5-Coder (2024-09) | Qwen3-Coder (2025-07) |
|---|---|---|---|
| 端侧 dense | 7B | 0.5B / 1.5B / 3B | 32B dense |
| 中型 MoE | 无 | 无 | 30B-A3B MoE |
| 旗舰 MoE | 无 | 无 | 480B-A35B MoE |
| 旗舰参数对比 | 7B | 32B (dense) | 480B (MoE) |
为什么 code LLM 要做到这个规模?因为 SWE-bench 这类工程评测需要:
- 长上下文理解(一次性看完整个仓库)
- 多步推理(先理解 bug、定位 root cause、写 fix、写测试)
- 跨语言能力(看 README/docs + 看代码)
- 工具调用能力(agentic:调用 grep / file_read / pytest)
这些能力的 emergence 阈值在 200B+ 范围——所以 frontier code LLM 必须做大。
7.2 跃迁 ②:Agentic Coding 路线
Qwen3-Coder 引入 agentic coding 训练范式——让模型学会”使用工具完成编程任务”,不是只输出代码块。
传统 code LLM:
  User: 修复 user.py 第 42 行的 NoneType 错误
  Model: [输出修复后的代码]

Qwen3-Coder agentic:
  User: 修复 user.py 第 42 行的 NoneType 错误
  Model:
    <tool>read_file("user.py", lines=30-60)</tool>
    <tool_response>...代码...</tool_response>
    <think>NoneType 错误的原因是第 42 行 user.email 为 None...</think>
    <tool>grep("email", recursive=True)</tool>
    <tool_response>... email 字段在多处使用 ...</tool_response>
    <tool>edit_file("user.py", 42, "if user.email:")</tool>
    <tool>run_tests("test_user.py")</tool>
    <tool_response>15/15 passed</tool_response>
    Final answer: 修复完成。原因是 user.email 可能为 None...
这种 agentic 行为在训练时通过multi-turn tool-use RL 优化——模型在合成的”buggy repository + test case”环境里反复尝试,奖励信号来自最终的 test pass 率。
Qwen3-Coder 在 SWE-bench Verified 上拿到 56.4——比传统 code-completion 类 LLM 显著领先。这是 agentic 训练带来的核心收益。
7.3 跃迁 ③:Built-in Thinking for Code
继承 Q4 Qwen-3 的 Built-in Thinking Mode,Qwen3-Coder 在代码任务上也支持 /think 与 /no_think 双模式:
/no_think:用于实时 IDE 补全场景——延迟低、直接出代码/think:用于复杂任务(debug、架构设计、复杂算法)——先输出<think>推理过程,再写代码
实测对比(SWE-bench Verified pass@1):
| 模式 | Qwen3-Coder-480B-A35B |
|---|---|
| /no_think | 49.8 |
| /think | 56.4 (+6.6) |
Thinking 模式带来 6.6 个点的提升——这与 Q4 中文本 thinking 的提升幅度(5-8 个点)一致。
八、与 DeepSeek-Coder 路线的对照
中国开源 code LLM 两条路径放在一起比:
| 维度 | Qwen-Coder 路线 | DeepSeek-Coder 路线 |
|---|---|---|
| 起点 | 2024-04 CodeQwen 1.5 (7B) | 2023-11 DeepSeek-Coder (1.3B-33B) |
| size 矩阵 | 0.5B / 1.5B / 3B / 7B / 14B / 32B / 30B-A3B / 480B (8 档) | 1.3B / 6.7B / 33B / V2-236B / V3-671B (5 档) |
| 与主线同步 | 与 Qwen-1.5/2.5/3 同代发布 | 与 V2/V3 主线异步 |
| 代码 tokens | 7.5T (Qwen3-Coder) | ~6T (V3-Coder, 估算) |
| 编程语言 | 100+ 完整覆盖 | 80+ 主流语言 |
| Repo-level 训练 | ✅ 借鉴 DeepSeek 范式 + 工程优化 | ✅ 原创范式(2023-11 paper 首次提出) |
| FIM 训练 | ✅ 标准实现 | ✅ 引入 PSM(Prefix-Suffix-Middle)变体 |
| Agentic coding | ✅ Qwen3-Coder 引入 | 弱(V3-Coder 有限支持) |
| Built-in Thinking | ✅ 继承 Qwen-3 | 通过 R1 走 reasoning specialist 路线 |
| ToB 商业化 | ✅ 阿里云 DashScope · 企业定制 | API + 开源生态 |
| 开源协议 | Apache 2.0 全 size | DeepSeek License(部分商用受限) |
核心差异:
- size 矩阵覆盖:Qwen-Coder 8 档 vs DeepSeek-Coder 5 档——Qwen 更”产品级”,DeepSeek 更”旗舰级”
- agentic 优先:Qwen3-Coder agentic 训练做得更早更系统——这与 Qwen-3.7-Max agent-first 战略 一脉相承
- 开源宽松度:Qwen-Coder 全系 Apache 2.0(商用零障碍)vs DeepSeek License(部分商业场景受限)
这两条路径各有优势——code LLM 工程师选 Qwen-Coder 是因为商用 license 友好 + size 矩阵全;选 DeepSeek-Coder 是因为创新机制(PSM-FIM、native sparse 等)以及 V3 系列的 frontier 性能(HumanEval 等评测略领先)。
九、Qwen-Coder 在 IDE 生态中的落地
Qwen-Coder 不只是论文里的模型——它已经深度集成进了多个开源 IDE 生态:
9.1 主流集成
| 平台 / 工具 | 集成时间 | 集成方式 |
|---|---|---|
| Cursor | 2025-08 | Pro 用户可选 Qwen3-Coder-480B 作为推理后端 |
| Continue.dev | 2024-10 | 开源 IDE 插件,默认支持 Qwen2.5-Coder |
| Aider | 2024-11 | terminal 编码 agent,Qwen3-Coder 在 SWE-bench 测试中表现最佳 |
| Cline (前身 Claude-Dev) | 2025-03 | VS Code agent,社区集成 Qwen2.5/3-Coder |
| Tabby | 2024-09 | 自托管 Copilot 替代品,主要 backend |
| CodeGeeX (清华系) | 2024-12 | 国内主流 IDE 插件 |
9.2 阿里云商业化
阿里云 DashScope(百炼)平台上 Qwen-Coder 是 ToB 高价值 SKU:
- API 定价:Qwen3-Coder-480B 输入 $0.60 / 1M tokens、输出 $2.40 / 1M tokens——比 Claude 3.5 Sonnet 便宜 5×、比 GPT-4o 便宜 8×
- 企业部署:阿里云提供”专有模型”服务,支持企业本地化部署 + 二次微调
- 教育版:Qwen3-Coder-30B-A3B 端侧 MoE 是阿里云教育平台首选的”低成本 code 教学模型”
9.3 开源社区贡献
Qwen-Coder 直接催生了多个上层项目:
- LLaMA-Factory:开源微调框架,Qwen2.5-Coder 是 default code 微调 backbone
- SwiftFinetuning:阿里云开源的 PEFT 框架,Qwen-Coder day-1 支持
- Qwen-Code 工具链:包括 code 数据清洗、合成代码生成、code-specific eval 套件
这种”模型 + 工具链 + 生态”的全栈支持,是 Qwen-Coder 区别于纯研究型 code LLM 的关键。
十、关键评测:SWE-bench / LiveCodeBench / HumanEval 三视角
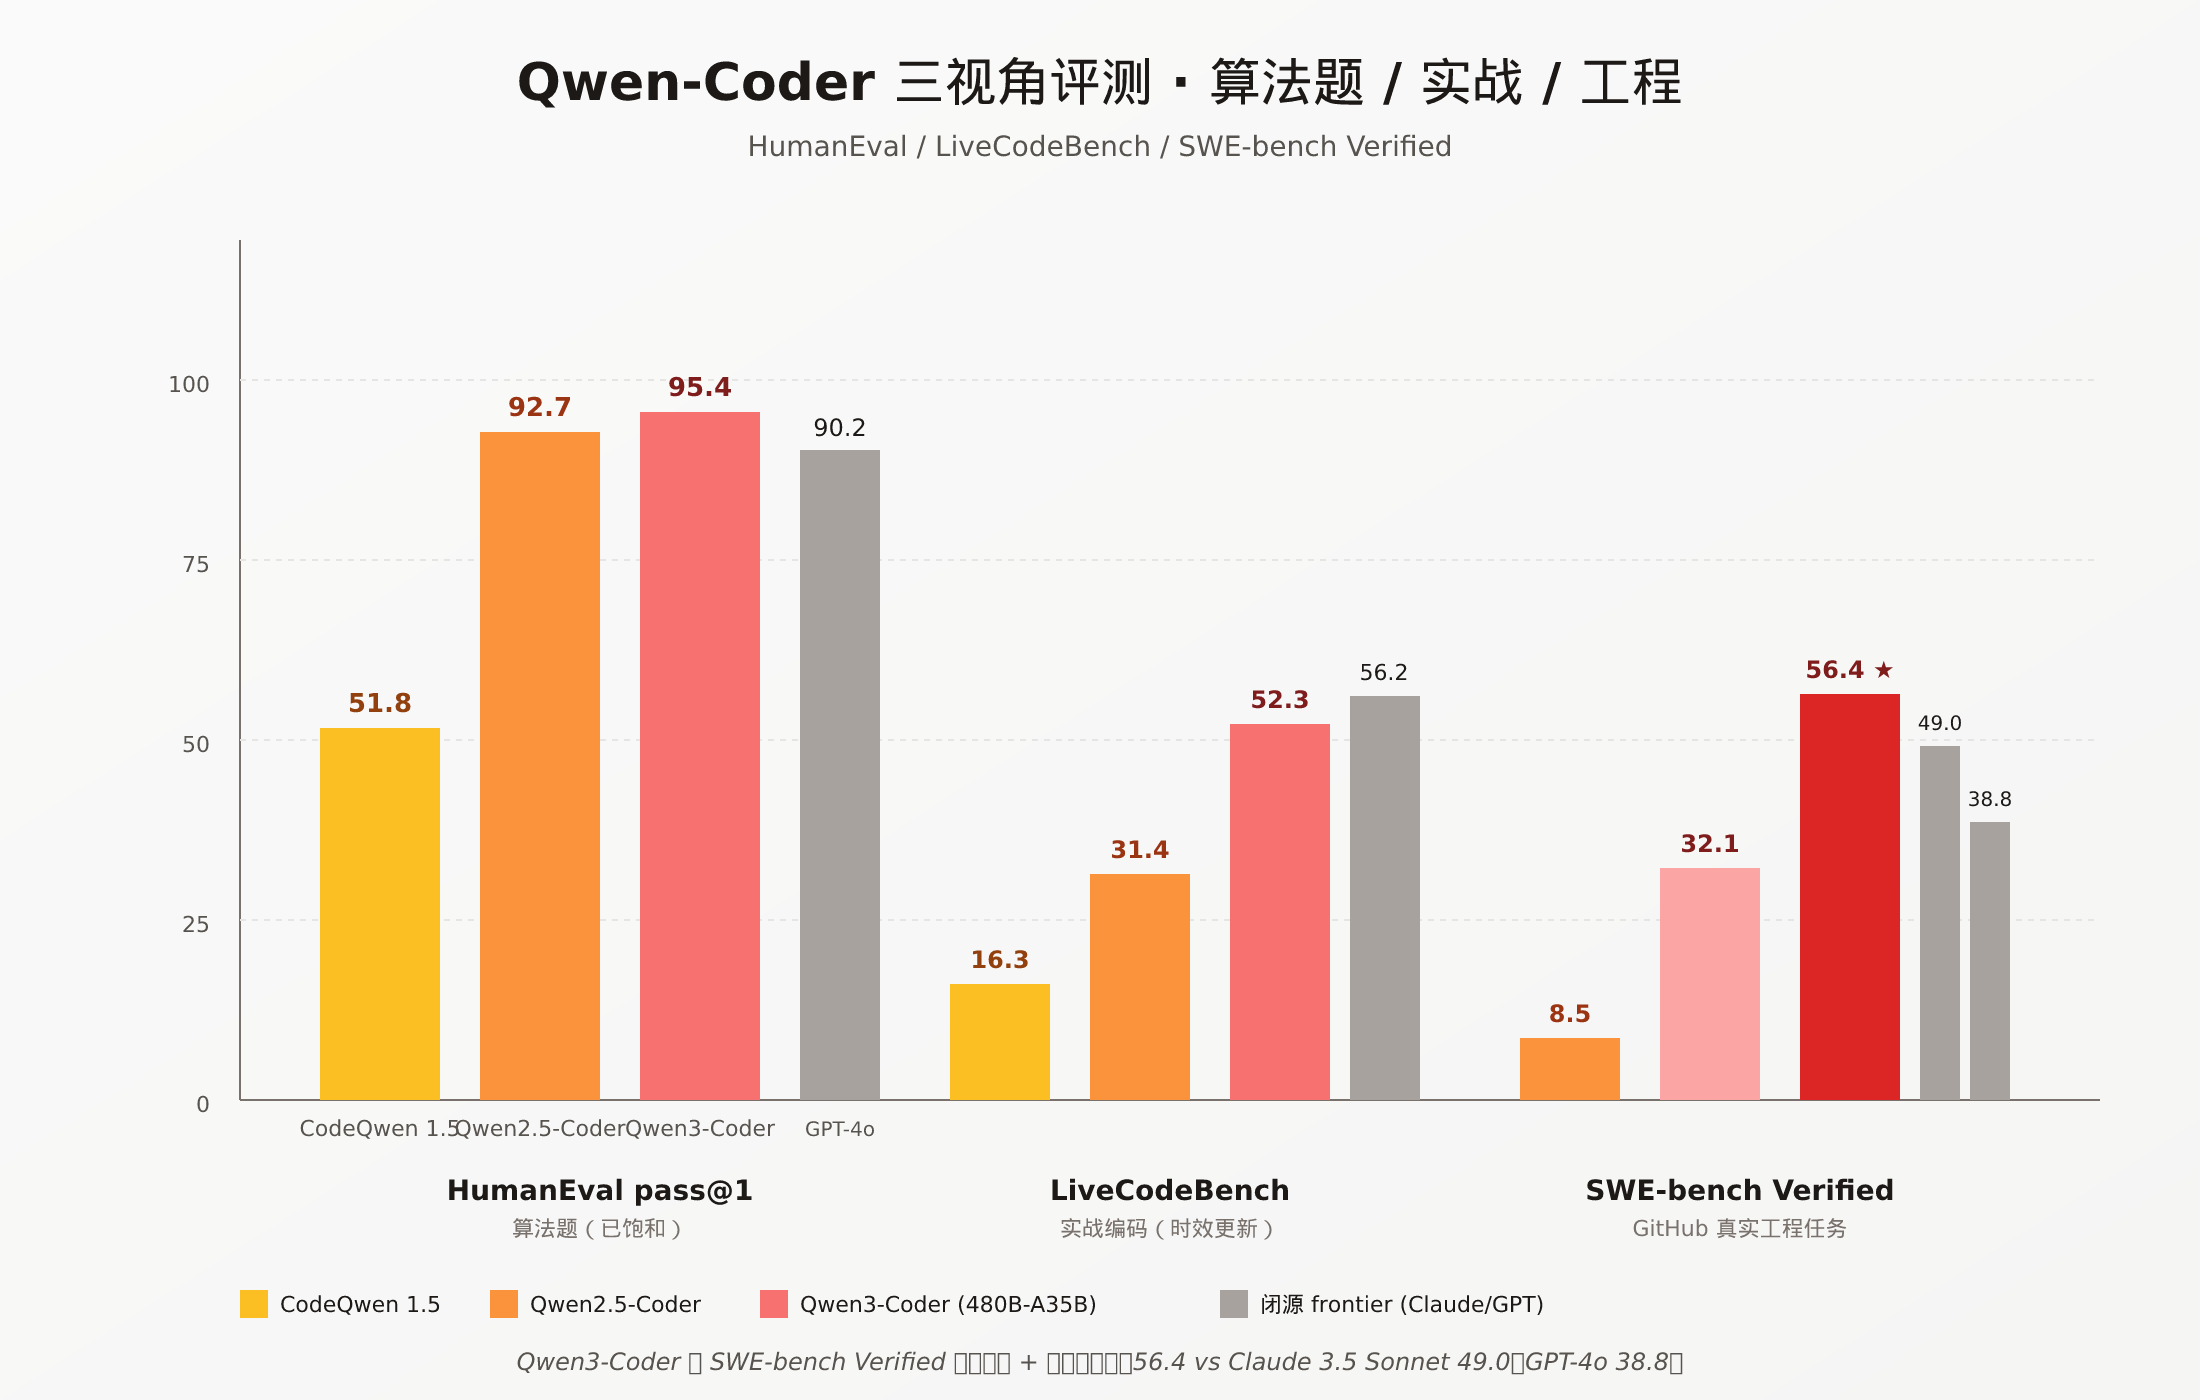
最后用三个最重要的 code LLM 评测把 Qwen-Coder 三代放在一起看:
10.1 HumanEval(算法题 pass@1)
| 模型 | 2024 H1 | 2024 H2 | 2025 H1 | 2025 H2 |
|---|---|---|---|---|
| CodeQwen 1.5-7B | 51.8 | — | — | — |
| Qwen2.5-Coder-7B | — | 88.4 | — | — |
| Qwen2.5-Coder-32B | — | 92.7 | — | — |
| Qwen3-Coder-32B | — | — | 94.5 | — |
| Qwen3-Coder-480B-A35B | — | — | — | 95.4 |
HumanEval 这条线 Qwen-Coder 从 51.8 涨到 95.4,几乎翻倍。到 95.4 这个区间,HumanEval 基本饱和——任何 frontier code LLM 都能拿 90+,分辨力下降。
10.2 LiveCodeBench(实战编码题,时效更新)
| 模型 | 2024 H1 | 2024 H2 | 2025 H1 | 2025 H2 |
|---|---|---|---|---|
| CodeQwen 1.5-7B | 16.3 | — | — | — |
| Qwen2.5-Coder-32B | — | 31.4 | — | — |
| Qwen3-Coder-32B | — | — | 45.2 | — |
| Qwen3-Coder-480B-A35B | — | — | — | 52.3 |
| (对比) Claude 3.5 Sonnet | — | — | — | 56.2 |
| (对比) GPT-4o | — | — | — | 49.7 |
LiveCodeBench 是 dynamic benchmark——题目每月更新,杜绝训练污染。这里 Qwen3-Coder 与 Claude 3.5 Sonnet 仍有 ~4 个点差距,但已经压过 GPT-4o。
10.3 SWE-bench Verified(GitHub 真实工程任务)
| 模型 | 2024 H1 | 2024 H2 | 2025 H1 | 2025 H2 |
|---|---|---|---|---|
| CodeQwen 1.5-7B | — | — | — | — |
| Qwen2.5-Coder-32B | — | 8.5 | — | — |
| Qwen3-Coder-32B | — | — | 32.1 | — |
| Qwen3-Coder-480B-A35B | — | — | — | 56.4 |
| (对比) Claude 3.5 Sonnet | — | — | — | 49.0 |
| (对比) GPT-4o | — | — | — | 38.8 |
| (对比) DeepSeek-Coder-V3 | — | — | — | 54.7 |
SWE-bench Verified 这条线 Qwen3-Coder 在 2025-07 时点是开源 + 闭源里最高的——这是 agentic coding 训练范式带来的回报。
十一、Qwen-Coder 三代演进的战略意义
把 CodeQwen 1.5、Qwen2.5-Coder、Qwen3-Coder 三代连起来看,几个关键判断:
11.1 Code LLM 是 Qwen 主线 ToB 最直接的变现路径
阿里云 ToB 商业化的客户群体里,软件开发企业占比超过 30%。Code LLM 直接对接这个市场——客户付费意愿强、技术门槛适中、ROI 清晰。
CodeQwen 1.5 起步时 Qwen-Coder 还在跟随 DeepSeek-Coder;到 Qwen3-Coder 已经做到 SWE-bench frontier 开源第一。这条路线的资源投入(估计 50+ 研究员、专门 GPU 集群)反映了阿里云的战略优先级。
11.2 agentic coding 是下一阶段的 differentiation
2025 下半年开始,code LLM 赛道的竞争从”算法题 benchmark”转向 agentic coding——能否在真实仓库里完成多步任务(read → think → tool-call → test → commit)。
Qwen3-Coder 在 SWE-bench Verified 上的 56.4 是这个赛道的领先信号。但这条路才刚开始——2026 年 Claude 3.7 Code mode、GPT-5 Code、Gemini 3 Code 都会进一步推进。Qwen 在这条路上的下一步是 Qwen-4-Coder(推测 2026 下半年发布)。
11.3 与 DeepSeek-Coder 的”中国开源 code LLM 双旗舰”格局确立
到 2025-07 时点,中国开源 code LLM 已经是全球 frontier 第一梯队——同时压过 GPT-4o + Code Llama,与 Claude 3.5 Sonnet 互有胜负。这是 Qwen + DeepSeek 两条路径共同的成果。
下一步看双方在 2026 年 agentic + multimodal code 路线上的分工——DeepSeek 可能继续走”少数旗舰 + 单点创新”,Qwen 可能继续走”全 size + agentic + ToB 商业化”。
十二、本篇收官 + 系列下一步
到这里 Qwen 系列已经发布 10 篇:
- 序章 Qwen 家族技术路线图
- 第 1 篇 Qwen-1 详解
- 第 2 篇 Qwen-2 详解
- 第 3 篇 Qwen-2.5 / 1M 详解
- 第 4 篇 Qwen-3 详解
- 第 5 篇 Qwen-3.5 详解
- 第 6 篇 Qwen-VL 系列详解
- 第 7 篇 Qwen-Audio 系列详解
- 第 8 篇 Qwen2.5-Omni 详解
- 第 9 篇 Qwen3-Omni → Qwen3.5-Omni 详解
- 第 10 篇 Qwen-Coder 系列详解(本篇)
接下来 5 篇:
- 第 11 篇:Qwen2.5-Math 详解(数学推理路线)
- 第 12 篇:QwQ 系列(QwQ-32B-Preview → QwQ-Max reasoning specialist)
- 第 13 篇:Qwen 工业落地与生态(LLaMA-Factory、SwiftFinetuning、vLLM 集成)
- 第 14 篇:Qwen vs DeepSeek vs LLaMA 三方对决收官篇
- 第 15 篇:Qwen 未来路线展望(Qwen-4 / agent / world model 推测)
下一篇见。
本系列所有文章会陆续发布在 yudonglee.me。Qwen 论文专题系列序章见 Qwen 家族技术路线图;与之对照的 DeepSeek 18 篇专题系列见 DeepSeek 技术路线图。

发表回复