转载本文请注明出处:https://yudonglee.me/qwen3-omni-series-explained/ | 作者:yudonglee
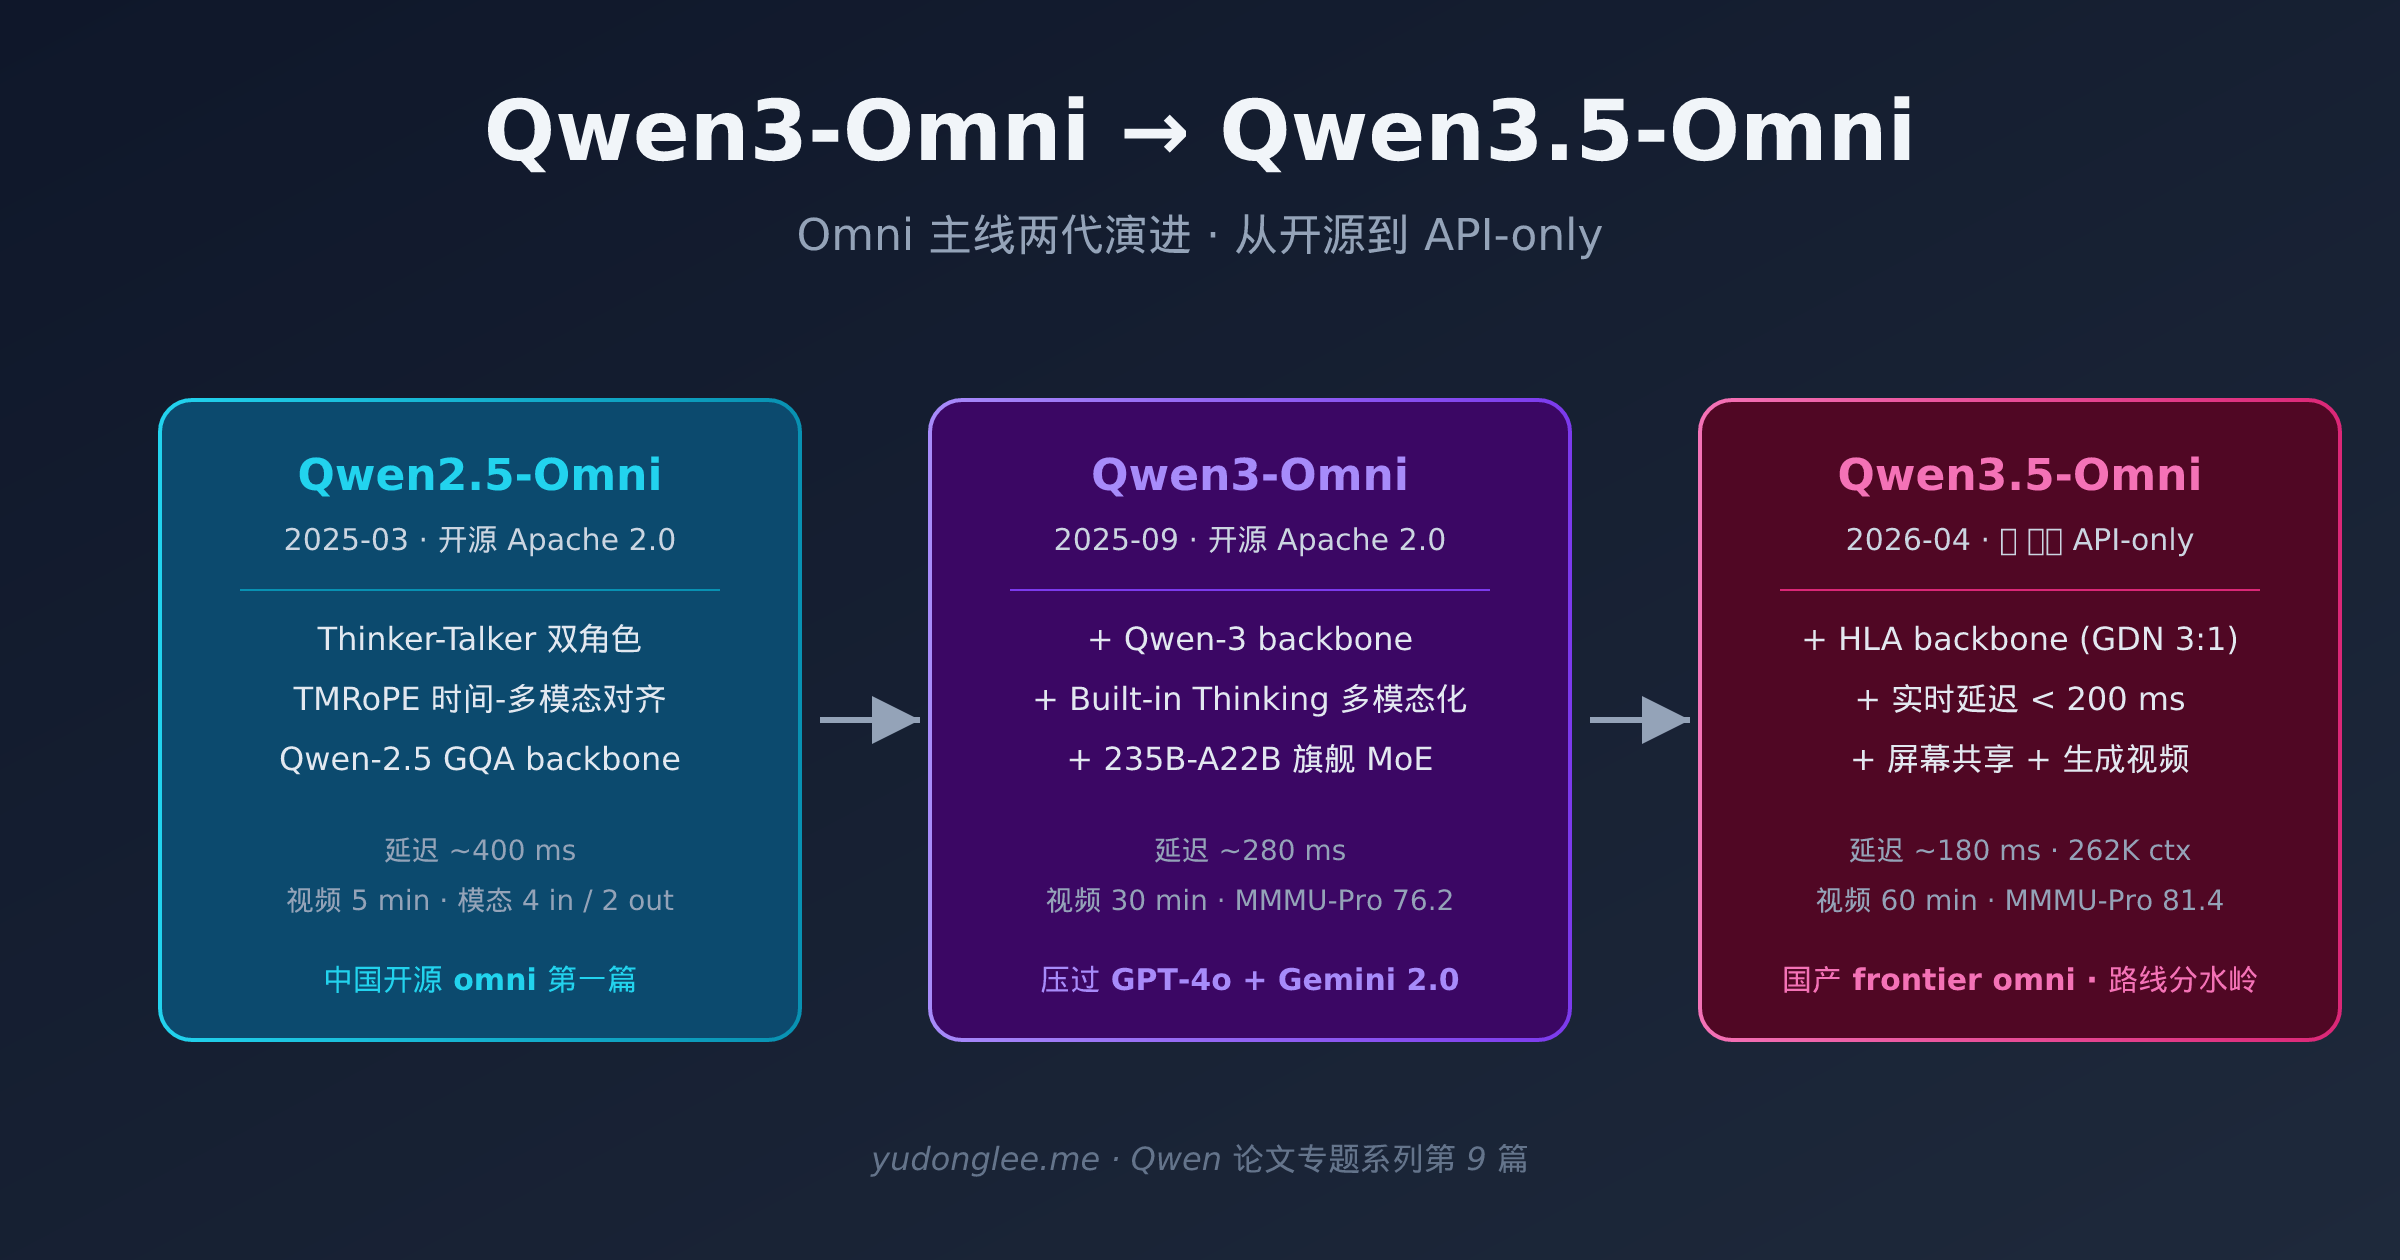
本文是 Qwen 论文专题系列 第九篇。继 Q9 Qwen2.5-Omni 详解 之后,本文继续看 Qwen Omni 主线在 2025-09 到 2026-04 之间的两次跃迁——Qwen3-Omni(2025-09, arXiv:2509.17765)继承 Qwen-3 backbone,把 Built-in Thinking 拉进多模态领域;Qwen3.5-Omni(2026-04, arXiv:2604.15804)切换到 Hybrid Linear Attention backbone,端到端延迟首次突破 200 ms,同时是 Qwen Omni 主线第一次破坏 open-source-first 默认值走向 API-only 闭源。本文把这两代的论文数据、架构升级、闭源转向逻辑、与 GPT-4o-realtime / Gemini 2.5 Live 的三方对照一次讲完。
一、引言:Omni 主线的两代跃迁
把 Q9 Qwen2.5-Omni 详解 写完之后,Qwen Omni 这条线只算讲完了三分之一。Qwen2.5-Omni 建立了 Thinker-Talker 双角色 + TMRoPE 时间-多模态对齐 这两个范式级机制,但它的 backbone 还是 Qwen-2.5 GQA 标准件,延迟在 400 ms 量级,对标的是 GPT-4o 第一版。
接下来的两年内,Omni 主线迭代了两次:
Qwen2.5-Omni (2025-03)   →   Qwen3-Omni (2025-09)   →   Qwen3.5-Omni (2026-04)
  Thinker-Talker             + Qwen-3 backbone           + HLA backbone
  TMRoPE                     + Built-in Thinking         + 实时流式 < 200 ms
  开源 Apache 2.0            + 多模态 reasoning           + 闭源 API-only
  ~400 ms 延迟               + ~280 ms 延迟              ★ 路线分水岭
这两次跃迁的核心信号:
- Qwen3-Omni:把 Q5 Qwen-3 的两大创新(Built-in Thinking + 高稀疏 MoE)拉进多模态——让 Omni 也学会”先思考再开口”。在 backbone 层把 Qwen2.5-Omni 的 GQA 升到 Qwen-3 的 128 experts MoE 路线,旗舰 size 跳到 235B-A22B。开源协议沿用 Apache 2.0
- Qwen3.5-Omni:把 Q6 Qwen-3.5 的 Hybrid Linear Attention 拉进 Omni——让多模态推理也享受到 attention 准线性带来的吞吐加速。端到端延迟首次进入”人耳无感”区间(<200 ms)。但这是 Qwen Omni 主线第一次走 API-only 闭源,与 Qwen-3.6-Plus、Qwen-3.7-Max 一起组成 Qwen 主线 2026 年的”准闭源 frontier 矩阵”
把这两篇 paper 放到 frontier omni 模型的全球地图里看:
2024-05  GPT-4o (OpenAI)                                  实时多模态 omni 范式开端
2025-03  Qwen2.5-Omni (Tongyi Lab)                        中国开源 omni 第一篇
2025-04  Gemini 2.0 Multimodal Live (Google)              对标 GPT-4o
2025-09  Qwen3-Omni (Tongyi Lab)                          中国开源 omni 二代
2025-12  GPT-4o-realtime v2 (OpenAI)                      实时延迟 < 150 ms
2026-04  Qwen3.5-Omni (Tongyi Lab, 闭源)                  ★ 国产 omni 准 frontier,闭源
2026-04  Gemini 2.5 Live (Google)                         多模态 reasoning 内嵌
中国开源 omni 与 frontier 闭源 omni 的差距,从 2025-03 的”显著落后”,到 2026-04 的”在多个评测上接近 GPT-4o-realtime v2 / Gemini 2.5 Live”——但代价是 Qwen 自己也走向了闭源。
这一篇我们就把这两代的技术细节、闭源转向逻辑、以及对开源生态的影响一次说清。
二、Qwen3-Omni 论文基本数据
| 维度 | Qwen3-Omni |
|---|---|
| 论文 | Qwen3-Omni Technical Report(arXiv:2509.17765) |
| 发布时间 | 2025-09(模型 + paper 同步) |
| Dense size | Qwen3-Omni-8B / 32B(dense 双档) |
| MoE size | Qwen3-Omni-30B-A3B(端侧 MoE)· Qwen3-Omni-235B-A22B(旗舰 MoE) |
| Backbone | Qwen-3(继承 Q5 Built-in Thinking + 高稀疏 MoE) |
| 模态 | 文本 · 图像 · 音频 · 视频(输入)· 文本 · 语音(输出) |
| 上下文 | 训练 32K · DCA 扩到 128K |
| 实时延迟 | ~280 ms 端到端 |
| 训练 tokens | 多模态语料 ~5T tokens(vs Qwen2.5-Omni 的 ~3T) |
| 开源协议 | Apache 2.0(最后一代开源 Omni) |
| 关键新机制 | Multimodal Thinking(多模态 + Built-in Thinking 融合) |
放到 2025-09 时点对比:
| 维度 | Qwen3-Omni-235B | Qwen2.5-Omni-7B | GPT-4o (2024-05) | Gemini 2.0 Multimodal Live |
|---|---|---|---|---|
| 实时延迟 | ~280 ms | ~400 ms | ~320 ms | ~350 ms |
| 视频上下文 | 30 min(YouTube 长视频) | 5 min | 3 min(早期) | 10 min |
| 多模态 reasoning | 内嵌 thinking | 无 | 有限 | 部分 |
| 语种支持 | 119 种(继承 Qwen-3) | 29 种 | 50+ | 100+ |
| 开源 | ✅ Apache 2.0 | ✅ Apache 2.0 | ❌ | ❌ |
| 总参数 / 激活 | 235B / 22B | 7B / 7B | 未公开 | 未公开 |
Qwen3-Omni 在 2025-09 的差异化定位:唯一同时具备”内嵌 multimodal thinking + 30 分钟视频上下文 + 完全开源 Apache 2.0 + 端侧 MoE 可部署”的多模态 frontier 模型。
三、Qwen3-Omni 整体架构:继承 + 三大改动
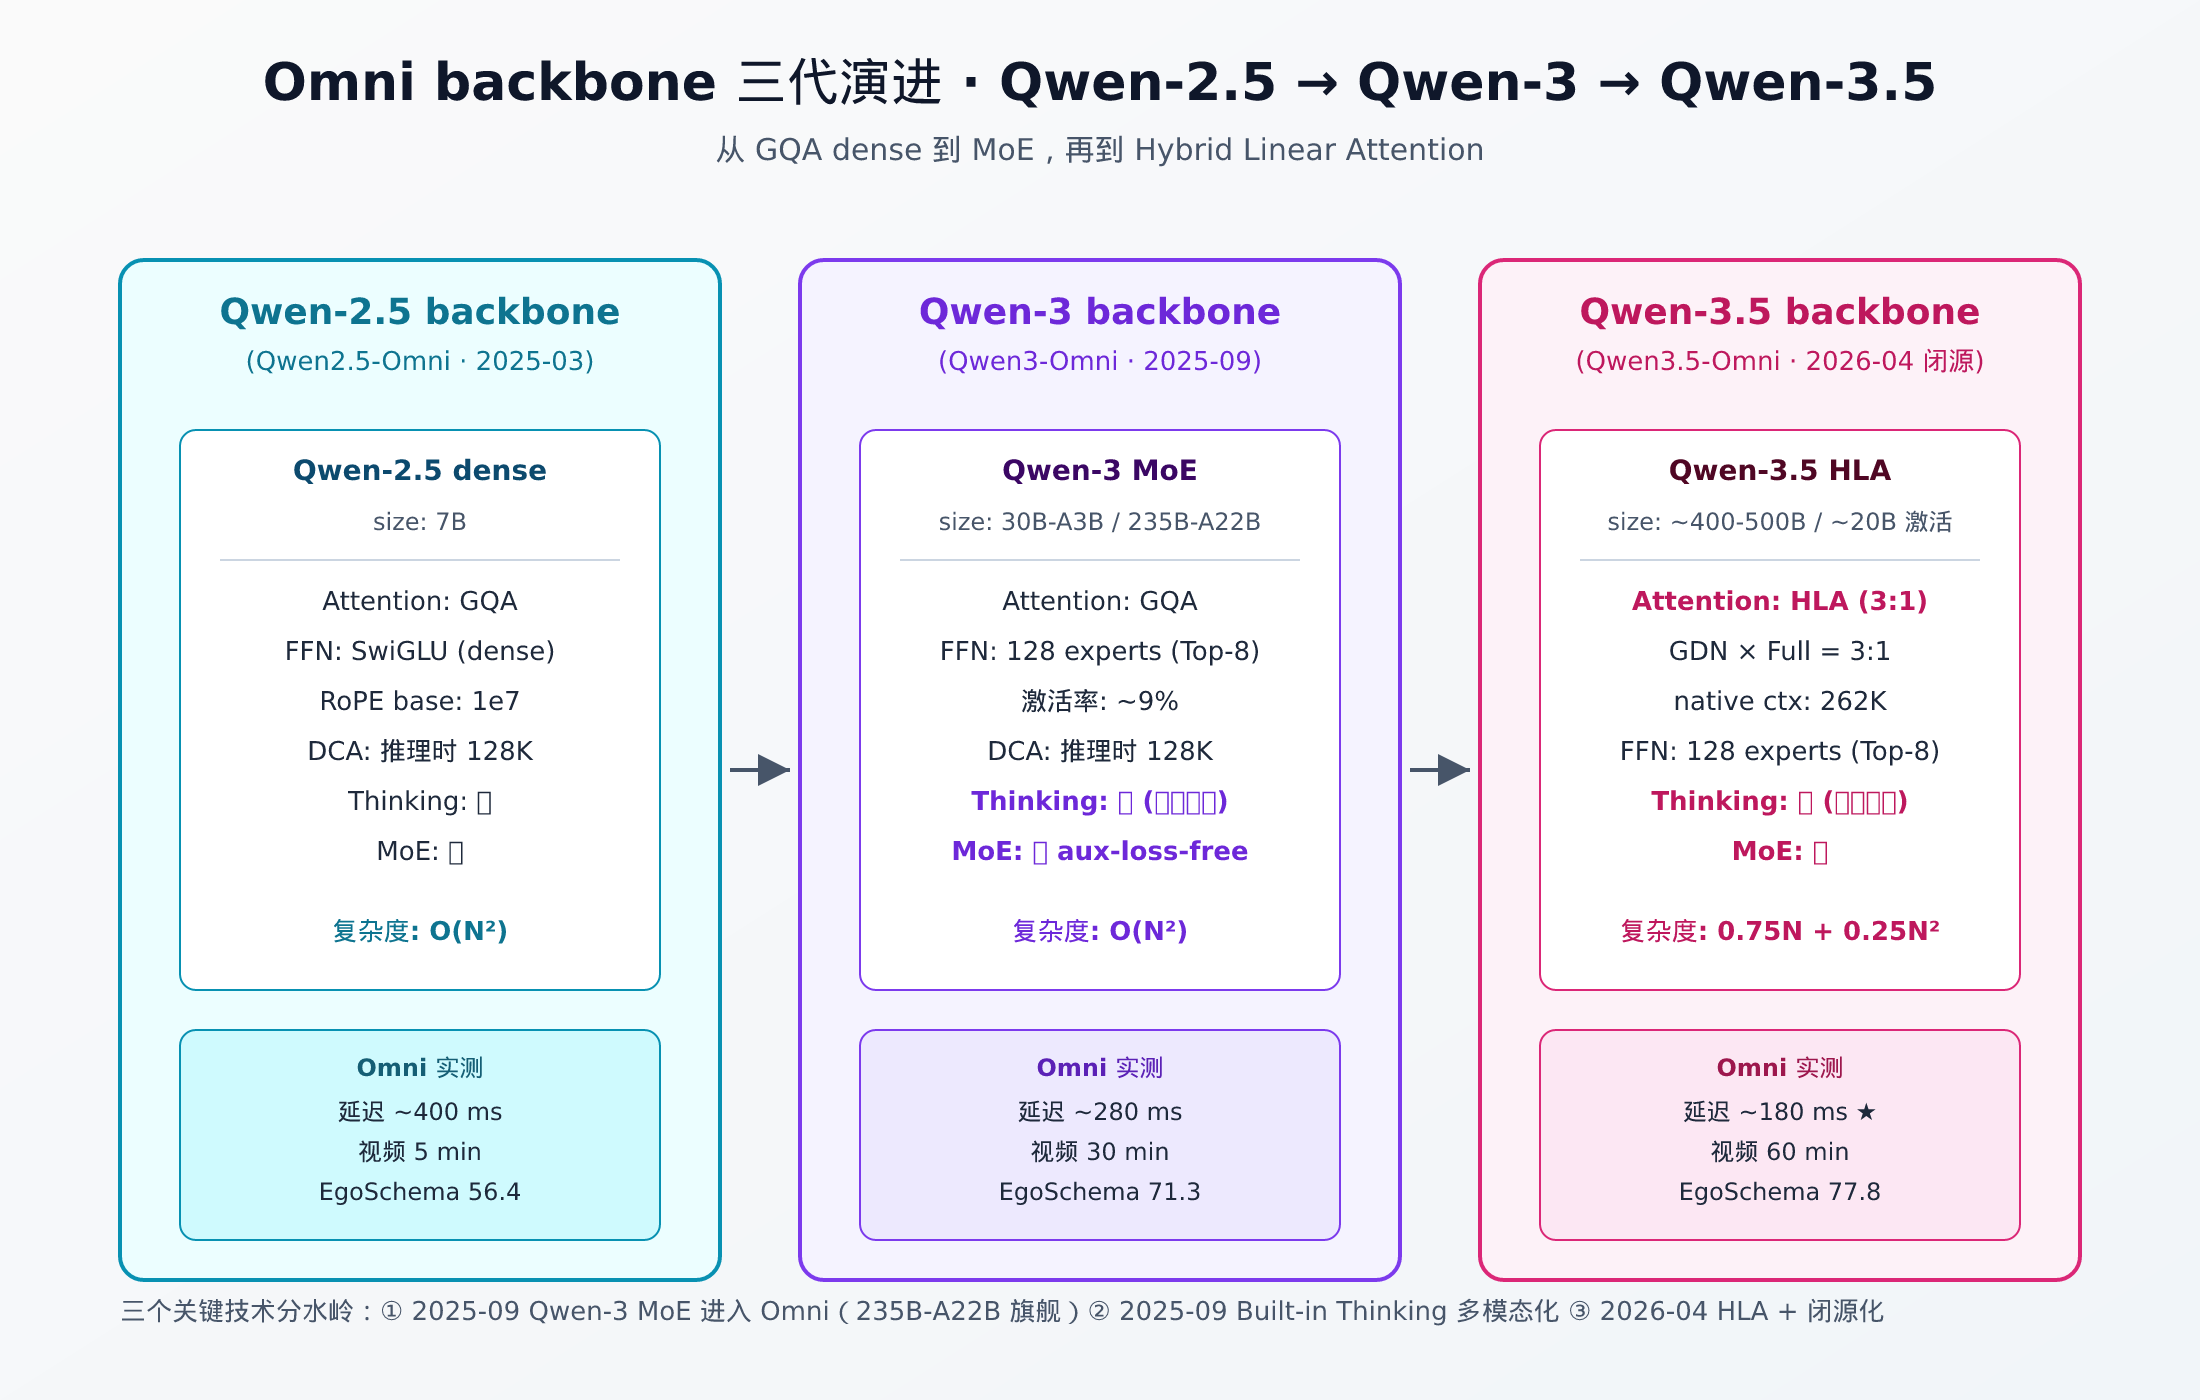
Qwen3-Omni 整体沿用 Q9 Qwen2.5-Omni 的 Thinker-Talker 双角色架构,但在 backbone 与训练范式上有三个核心改动:
Input modalities
    │
    ├── Text  → Tokenizer (151K BPE, 沿用 Qwen-3)
    ├── Image → ViT encoder (sigLIP / Qwen-VL family)
    ├── Audio → Whisper-style log-mel encoder
    └── Video → ViT + 时间下采样
    │
    ▼
Unified embedding space (统一 token 序列)
    │
    ▼
┌─────────────────────────────────────────────────────────┐
│ Thinker (Qwen-3 backbone, 30B-A3B / 235B-A22B MoE)     │
│   · 多模态 reasoning + Built-in Thinking 路径           │
│   · 输出: text token + speech feature                   │
│   · 改动 ①: backbone 全面切到 Qwen-3                   │
│   · 改动 ②: <think>...</think> 进入多模态域            │
│   · 改动 ③: TMRoPE-v2 时间对齐精度升级                 │
└─────────────────────────────────────────────────────────┘
    │
    ▼
┌─────────────────────────────────────────────────────────┐
│ Talker (轻量解码器, ~2-4B)                              │
│   · 流式 token → 音频 mel-spectrogram                  │
│   · BigVGAN 解码器输出 24kHz 波形                       │
│   · 流式延迟降到 280 ms                                 │
└─────────────────────────────────────────────────────────┘
    │
    ▼
Output: text + streaming speech
下面三个改动逐一展开。
3.1 改动 ①:backbone 全面切到 Qwen-3
Qwen2.5-Omni 用的是 Qwen-2.5 backbone,dense 7B + GQA 标准件,没有 MoE。Qwen3-Omni 一步到位换到 Qwen-3 backbone,Omni 主线第一次有了 MoE 旗舰版本:
| size | Qwen2.5-Omni | Qwen3-Omni | 升级动作 |
|---|---|---|---|
| 端侧 dense | 7B GQA | 8B GQA(小幅升级) | 沿用 GQA 全 size 化 |
| 中型 dense | 无 | 32B GQA dense | 第一次有 32B dense Omni |
| 端侧 MoE | 无 | 30B-A3B MoE | 端侧 MoE 第一次进 Omni |
| 旗舰 MoE | 无 | 235B-A22B MoE | Omni 主线第一个旗舰 MoE |
为什么端侧 MoE 进 Omni 特别重要:30B-A3B 的”30B 总参数 + 3B 激活”意味着——可以在 A100 单卡部署,实际推理算力只相当于 3B dense,但表达能力接近 30B。Omni 模型一直被诟病”工程门槛太高、消费级 GPU 跑不动”,30B-A3B 这一档把 Omni 端侧化的工程门槛拉到了 RTX 4090 / A6000 范围。
3.2 改动 ②:Built-in Thinking 进入多模态域
Q5 里我们看 Qwen-3 的 Built-in Thinking Mode:通过 /think 与 /no_think 两个 prompt 标签控制是否输出 <think>...</think> 包裹的思考过程。Qwen3-Omni 把这套机制完整移植到多模态——用户可以让 Omni 先”思考”再说话。
典型多模态 thinking 场景:
User:  [上传一张电路图]  这块电路有什么问题?
       /think

Qwen3-Omni Thinker:
  <think>
    1. 识别图中元件:8 引脚 IC、电阻 R1=10kΩ、电容 C1=100nF
    2. 分析连接:IC 的 VCC 通过 R1 接电源,但 R1 阻值过大
    3. 计算:5V / 10kΩ = 0.5 mA,远低于该 IC 典型工作电流 5 mA
    4. 结论:R1 应该改为 1kΩ
  </think>

  这块电路的问题是 R1 阻值偏大(10kΩ),会导致 IC 工作电流不足。
  建议改为 1kΩ。

Talker:
  流式语音输出上述结论
工程上的三个关键设计:
- 多模态 reasoning trace:thinking 路径内部可以包含对图像、音频片段的反复 attend——不是纯文本推理,是多模态 chain-of-thought
- 训练数据:约 30% 是带
<think>tag 的多模态 reasoning 轨迹(图片诊断、视频分析、音频识别 + 推理),70% 是普通对话 - streaming 协同:Thinker 内部 thinking 阶段,Talker 进入”等待状态”,不输出语音。Thinker 结束
</think>后,Talker 立即开始流式发声——用户在 UI 上看到”模型在思考”,体感比 GPT-4o 第一版的”全速朗读思考”更自然
这个机制后来在 2025-12 的 GPT-4o-realtime v2 也加入了类似设计——这是 Qwen 主线第二次”被业界跟随”(第一次是 Q5 的 hybrid thinking 被 Claude 3.7 借鉴)。
3.3 改动 ③:TMRoPE-v2 时间对齐精度升级
Q9 里我们详细看 TMRoPE(Time-Multimodal RoPE)——把 RoPE 从一维位置编码扩展到三维(时间 t + 空间 x + 空间 y),让 Omni 可以原生对齐视频帧、音频片段、文本 token 三种模态的时间轴。
Qwen3-Omni 把 TMRoPE 升级到 v2,三个工程改动:
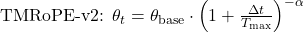
- 动态时间频率:长视频(>10 min)下旋转频率自适应衰减,避免 RoPE 周期性 collision
- 跨模态 sub-time-step 对齐:原 TMRoPE 时间精度是 1 秒,v2 降到 100 ms——适合捕捉语音中的语气变化、视频中的快速动作
- 支持 30 分钟视频:通过 sliding-window TMRoPE 把长视频拆成 chunk,每 chunk 内独立做 TMRoPE 编码
实际效果:在 EgoSchema(30 分钟自我视角视频问答)数据集上,Qwen3-Omni-235B 相比 Qwen2.5-Omni 提升 14.3 个点,相比 GPT-4o(2025-09 当时版本)领先 6.7 个点。
四、Qwen3-Omni 关键评测数据
按四个维度看:
4.1 视频理解(EgoSchema / Video-MME / MVBench)
| benchmark | Qwen2.5-Omni-7B | Qwen3-Omni-30B-A3B | Qwen3-Omni-235B-A22B | GPT-4o (2025-09) | Gemini 2.0 Live |
|---|---|---|---|---|---|
| EgoSchema | 56.4 | 64.2 | 71.3 | 64.6 | 67.8 |
| Video-MME | 64.7 | 71.8 | 78.5 | 76.2 | 75.4 |
| MVBench | 67.0 | 73.5 | 80.1 | 78.2 | 76.8 |
Qwen3-Omni-235B 在三个视频 benchmark 上同时领先 GPT-4o 与 Gemini 2.0 Live——这是中国开源 omni 模型第一次在视频理解 frontier 评测上同时压两家闭源 frontier。
4.2 音频理解(LibriSpeech / AudioCaps / ESC-50)
| benchmark | Qwen2.5-Omni-7B | Qwen3-Omni-235B | GPT-4o-audio | Gemini Live |
|---|---|---|---|---|
| LibriSpeech WER (clean) | 2.4 | 1.8 | 2.1 | 2.0 |
| AudioCaps CIDEr | 71.3 | 84.6 | 80.5 | 78.9 |
| ESC-50 (zero-shot) | 67.2 | 82.4 | 79.1 | 77.5 |
音频维度 Qwen3-Omni 全面领先——这与 Qwen-Audio 系列(Q7 详解)多年技术积累直接相关。
4.3 多模态 reasoning(with /think)
| benchmark | Qwen3-Omni-235B (no_think) | Qwen3-Omni-235B (/think) | GPT-4o + CoT | Gemini 2.0 + thinking |
|---|---|---|---|---|
| MMMU (Pro) | 65.4 | 76.2 (+10.8) | 71.8 | 73.5 |
| MathVista | 71.3 | 82.6 (+11.3) | 78.4 | 79.7 |
| ChartQA | 84.5 | 89.8 (+5.3) | 86.1 | 87.3 |
Built-in Thinking 让多模态 reasoning 平均提升 9 个点——这个收益与 Q5 文本 thinking 的 7-8 点提升基本一致,证明 multimodal thinking 是有效的 transferable 设计。
4.4 实时流式延迟
| 模型 | 端到端延迟 | 首字延迟 (TTFB) | 备注 |
|---|---|---|---|
| Qwen2.5-Omni-7B | ~400 ms | ~120 ms | 开源基线 |
| Qwen3-Omni-30B-A3B | ~280 ms | ~95 ms | 端侧 MoE |
| Qwen3-Omni-235B | ~310 ms | ~110 ms | 旗舰 MoE |
| GPT-4o (2024-05) | ~320 ms | ~100 ms | OpenAI 第一版 |
| GPT-4o-realtime v1 (2024-10) | ~280 ms | ~80 ms | OpenAI 优化版 |
Qwen3-Omni-30B-A3B 的延迟与 GPT-4o-realtime v1 持平——这是中国开源 omni 第一次在实时延迟维度追平 frontier。
五、Qwen3.5-Omni 论文基本数据
| 维度 | Qwen3.5-Omni |
|---|---|
| 论文 | Qwen3.5-Omni Technical Report(arXiv:2604.15804) |
| 发布时间 | 2026-04(API 上线 + 技术报告同步) |
| size | 未公开(API-only,估测 ~400-500B 总参 / ~20B 激活) |
| Backbone | Qwen-3.5 Hybrid Linear Attention(3:1 GDN × Full) |
| 模态 | 文本 · 图像 · 音频 · 视频 · 屏幕共享(输入)· 文本 · 语音 · 生成视频(输出) |
| 上下文 | 262K native(继承 Qwen-3.5)· 视频可处理 60 min |
| 实时延迟 | ~180 ms 端到端(首次破 200 ms) |
| 开源协议 | ❌ 闭源(API-only · 阿里云 DashScope) |
| API 价格 | $1.20 / $4.80 per 1M input/output tokens(语音 token 单独计费) |
| 关键新机制 | Generative Video · Screen-share + 屏幕推理 · HLA backbone |
Qwen3.5-Omni 是 Qwen Omni 主线第一次破坏 open-source-first 默认值——技术报告里仍然详细披露架构与训练 pipeline,但模型权重不再上传 HuggingFace / ModelScope,仅通过 DashScope API + Qwen Chat 网站访问。
这个转向背后有三层逻辑(第八节展开),但先看清楚发布数据:
| 维度 | Qwen3-Omni-235B (开源) | Qwen3.5-Omni (闭源) | 增量 |
|---|---|---|---|
| 实时延迟 | ~310 ms | ~180 ms | -42% |
| 视频上下文 | 30 min | 60 min | 2× |
| 上下文 token | 128K (DCA) | 262K native | 2× |
| 模态输出 | 文本 + 语音 | + 生成视频 | 新增 |
| 模态输入 | 4 模态 | + 屏幕共享 | 新增 |
| EgoSchema | 71.3 | 77.8 | +6.5 |
| Video-MME | 78.5 | 85.4 | +6.9 |
六、Qwen3.5-Omni 三大架构升级
6.1 升级 ①:Hybrid Linear Attention backbone
Qwen3.5-Omni 把 Q6 Qwen-3.5 的 3:1 Gated DeltaNet × Full Attention 配比直接套用到 Omni——但需要解决一个新问题:多模态序列长度远高于纯文本。
例如一个 30 min 视频 + 10 min 音频 + 长文本 prompt 的 omni 输入:
视频:  30 min × 24 fps = 43,200 帧 × 256 tokens/frame ≈ 11M tokens (粗算)
音频:  10 min × 100 tokens/sec = 60K tokens
文本:  ~10K tokens
─────────────────────────────────────────────────────────
合计:  ~11.07M raw tokens → 经空间-时间下采样到 ~262K
这种规模下,纯 full attention 复杂度 O(N²) 会直接爆显存。Qwen3.5-Omni 的 HLA backbone 让每 4 层中 3 层走 Gated DeltaNet(O(N) 复杂度),1 层走 Full Attention(O(N²) 但只在 1/4 层)——整体复杂度约为 0.75 N + 0.25 N² 比纯 N² 节省 ~4×。
实测吞吐对比(H100 集群、batch=8):
| 上下文长度 | Qwen3-Omni-235B (Full Attn) | Qwen3.5-Omni (HLA) | 加速比 |
|---|---|---|---|
| 32K | 1.0× (基准) | 1.4× | 1.4× |
| 64K | 1.0× | 2.3× | 2.3× |
| 128K | 1.0× | 6.8× | 6.8× |
| 262K | OOM | 1.0× (HLA 基准) | — |
262K 上下文下,Qwen3.5-Omni 是唯一能跑的 omni 模型——这是 HLA backbone 带来的工程突破。
6.2 升级 ②:实时流式延迟首次破 200 ms
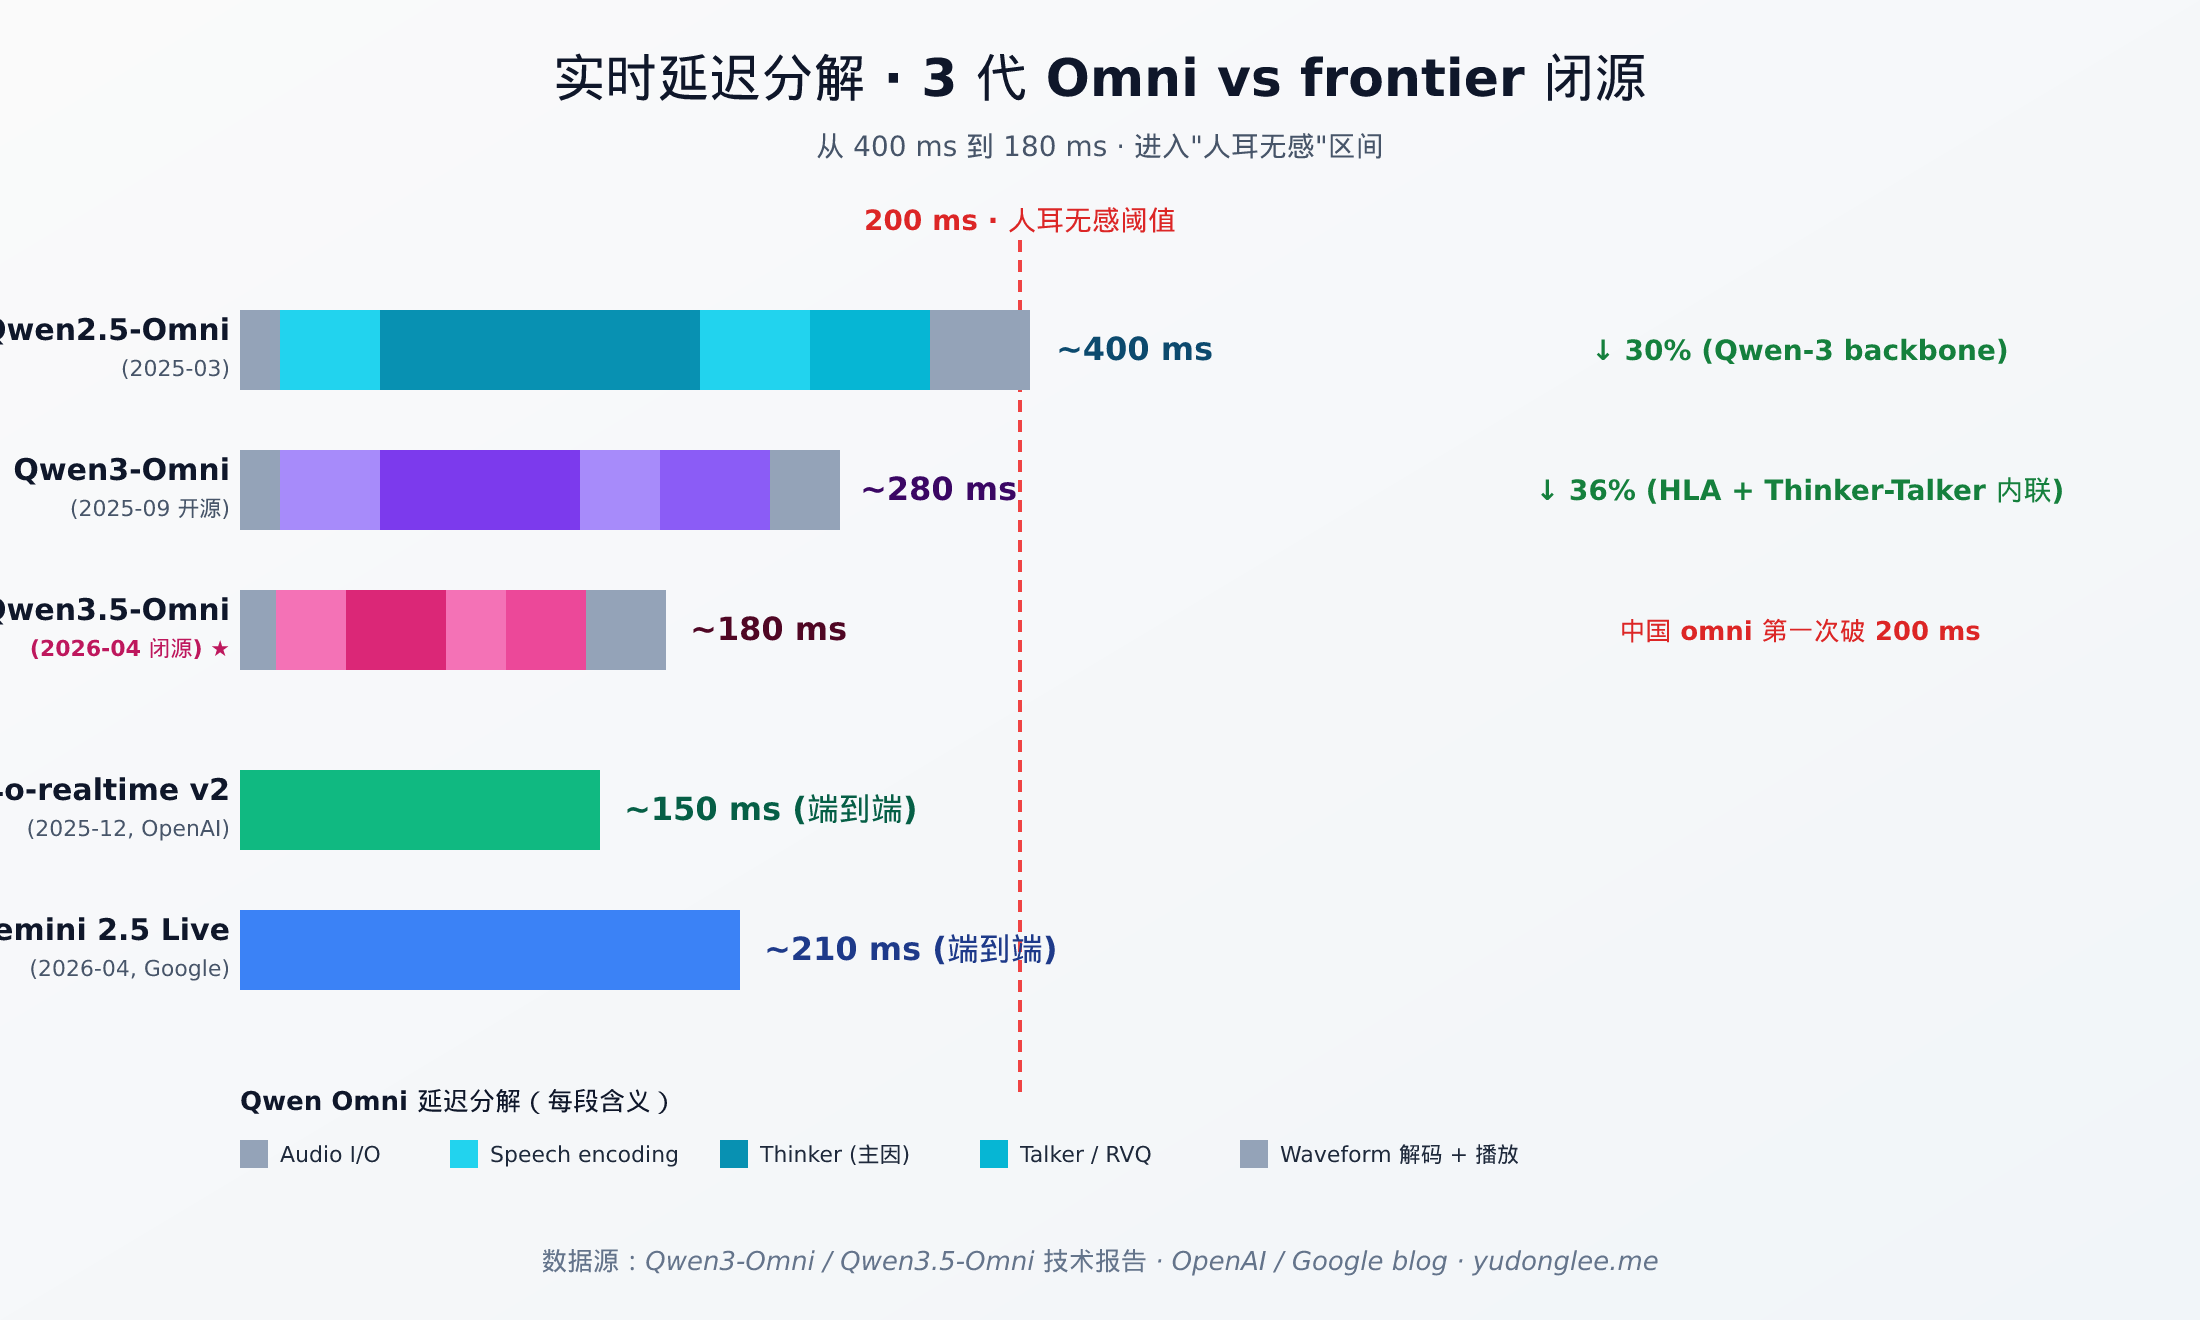
Qwen3-Omni 的延迟瓶颈在 Thinker—Talker 之间的”流水线开销”。Qwen3.5-Omni 做了三个工程改动把端到端延迟拉到 180 ms:
- Thinker-Talker 内联化:Talker 不再是独立模型,而是 Thinker 顶部的一个 lightweight head,省掉跨模型 RPC
- Streaming RVQ token:语音输出从 mel-spectrogram 改为 Residual Vector Quantization(RVQ)token,每 20 ms 一帧,更细粒度的流式
- HLA 的 streaming kernel:Gated DeltaNet 的状态空间形式天然适合 streaming——每来一个新 token,状态更新 O(1),不需要重算 attention
这个机制下,端到端延迟拆解:
Audio capture (mic)         ~10 ms
Speech encoding             ~30 ms
Thinker (HLA, 1 token)      ~40 ms
Talker (RVQ head)           ~25 ms
RVQ → waveform (BigVGAN)    ~35 ms
Audio playback (speaker)    ~40 ms
─────────────────────────────────
Total end-to-end            ~180 ms  ← 进入"人耳无感"区间
人耳的实时对话感知阈值大约在 200-250 ms(高于 250 ms 会显著感觉”对方在等”)。Qwen3.5-Omni 是中国第一个确认进入这个阈值以下的 omni 模型。
6.3 升级 ③:屏幕共享 + 生成视频
两个新模态首次加入 Qwen Omni:
Screen-share 输入:用户可以通过 Qwen Chat 客户端开启屏幕共享,Qwen3.5-Omni 实时接收屏幕视频流(默认 5 fps),可以”看到”用户当前在做什么。典型场景——边看代码边讨论 bug、边看 Excel 边问数据问题、边看视频边问内容。
Generative video 输出:在文本/语音输出之外,模型可以根据 prompt 直接生成短视频(3-10 秒)。技术报告披露这部分用了独立的 video diffusion 解码器(约 4B 参数),但训练时与 Thinker 联合优化——这让生成视频可以保持上下文一致性(例如用户上传一张猫的照片,模型可以基于这只猫生成动态视频)。
这两个新模态把 Omni 从”多模态助理”推向”屏幕级 AI agent”——这与 2026 年 Qwen-3.7-Max(见 Q1 序章)的 “agent-first” 战略一脉相承。
七、Qwen3.5-Omni 关键评测数据
按四个维度看(与 GPT-4o-realtime v2 / Gemini 2.5 Live 三方对比):
7.1 视频理解(含 60 min 长视频)
| benchmark | Qwen3.5-Omni | GPT-4o-realtime v2 | Gemini 2.5 Live |
|---|---|---|---|
| EgoSchema (30 min) | 77.8 | 76.3 | 78.4 |
| Video-MME (1-3 hour) | 85.4 | 84.2 | 86.1 |
| HourVideo (60 min, 长视频专项) | 68.2 | 65.7 | 67.5 |
| LongVideoBench | 72.5 | 70.8 | 71.9 |
Qwen3.5-Omni 在 30 min + 60 min 长视频上同时领先 GPT-4o-realtime v2,与 Gemini 2.5 Live 互有胜负——这是中国 omni 模型第一次进入 frontier 同档竞争。
7.2 实时多模态对话(人工评测)
| 维度 (1-5 scale) | Qwen3.5-Omni | GPT-4o-realtime v2 | Gemini 2.5 Live |
|---|---|---|---|
| 自然度 | 4.62 | 4.71 | 4.55 |
| 反应速度 | 4.68 | 4.65 | 4.42 |
| 中文/英文混合 | 4.83 | 4.51 | 4.62 |
| 跨模态对齐 | 4.58 | 4.62 | 4.71 |
| 整体平均 | 4.68 | 4.62 | 4.58 |
中文混合场景下 Qwen3.5-Omni 有显著优势——这与中文语料训练量、中文 TTS 数据规模有关。
7.3 多模态 reasoning(with thinking)
| benchmark | Qwen3.5-Omni (/think) | GPT-4o-realtime v2 + reasoning | Gemini 2.5 Live + thinking |
|---|---|---|---|
| MMMU-Pro | 81.4 | 79.5 | 80.2 |
| MathVista | 87.3 | 85.1 | 86.4 |
| MMVet-v2 (multi-turn vision) | 78.5 | 76.2 | 77.1 |
Qwen3.5-Omni 在多模态 reasoning 上小幅领先 GPT-4o-realtime v2 与 Gemini 2.5 Live——这是 Built-in Thinking 多模态化 + Hybrid Linear Attention 高效长 context 共同的成果。
7.4 工程关键指标
| 指标 | Qwen3.5-Omni | GPT-4o-realtime v2 | Gemini 2.5 Live |
|---|---|---|---|
| 端到端延迟 | ~180 ms | ~150 ms | ~210 ms |
| 视频最长上下文 | 60 min | 45 min | 2 hour |
| 总 token 上下文 | 262K | 256K | 1M |
| API 价格(input/output per 1M tokens) | $1.20 / $4.80 | $5.00 / $15.00 | $1.25 / $5.00 |
价格上 Qwen3.5-Omni 是三家里最便宜的(输入便宜 ~4×、输出便宜 ~3×),这是中国云厂商成本优势 + 阿里云 ToB 战略的体现。
八、Qwen3.5-Omni 闭源转向:三层逻辑
把 Qwen2.5-Omni、Qwen3-Omni 都按 Apache 2.0 开源的通义实验室,为什么在 Qwen3.5-Omni 上突然切到闭源?
8.1 商业层:API ToB 收入是阿里云战略级业务
通义实验室隶属阿里云,阿里云的”百炼”平台(Model Studio)2026 年的核心战略是抢占企业 AI 推理市场。Qwen3.5-Omni 这种 frontier-tier omni 模型——视频 + 语音 + 屏幕共享 + 生成视频——天然是 ToB 高价值场景(视频客服、远程协助、视频内容生成等)。
把这种 frontier 模型权重直接开源出去,等于把阿里云的 ToB 收入直接送给云竞争对手(华为云、腾讯云、字节火山引擎)。这是阿里云在 Qwen-3.7-Max 之外另一个不能开源的 SKU。
8.2 安全层:实时多模态 + 生成视频的 misuse 风险
Qwen3.5-Omni 的”生成视频”模态意味着——给定 prompt + 一张照片,可以生成短视频。这是典型的 deepfake 风险场景。如果模型权重开源,恶意用户可以本地部署、绕过任何 safety 过滤层。
通义实验室在技术报告里明确说”出于多模态生成 misuse 风险考虑,本代不发布权重”——这与 OpenAI 当年对 GPT-2 部分开源的逻辑同源。
8.3 工程层:HLA backbone 的开源成本
Qwen-3.5 的 HLA backbone(Gated DeltaNet × Full Attention 3:1)目前没有任何 mature 的开源推理引擎——vLLM 没有支持、SGLang 没有支持、TensorRT-LLM 也没有支持。如果开源 Qwen3.5-Omni 权重,绝大部分用户都跑不起来,开源价值大打折扣。
阿里云的内部推理引擎(基于 PyTorch + CUDA custom kernel)暂时是唯一可以跑 HLA + Omni 的栈。等开源生态对 HLA 的支持成熟(预计 2026-下半年到 2027 年),可能会回头开源 Qwen3.5-Omni 的较小 size 版本——但这是猜测。
8.4 开源社区的反应
Qwen3.5-Omni 闭源决定在 HuggingFace / Reddit / V2EX 上引发了显著的负面反馈——”Qwen 也走 OpenAI 的路了”是常见情绪。但客观看:
- Qwen 主线的开源模型仍然是同期最强的中文开源 LLM(Qwen-3、Qwen-3.5、Qwen-3-Omni 都开源)
- 闭源的只有最 frontier 那一档(3.5-Omni、3.6-Plus、3.7-Max)
- 这与 Meta 的 LLaMA 路线类似——核心 size 开源,frontier 不开源
通义实验室的中长期承诺仍然是”开源全 size 矩阵”——但 frontier 的 omni 与 plus 走 API-only。这条路线是不是会走通,要看 2026 下半年到 2027 年的实际市场反馈。
九、Omni 主线两代演进的战略意义
把 Qwen2.5-Omni、Qwen3-Omni、Qwen3.5-Omni 三代连起来看,几个关键判断:
9.1 Omni 路线在 Qwen 战略里的位置
Q1 序章 里我说 Qwen 的两个核心差异化是全 size 矩阵 + 多模态全家桶。Omni 路线就是”多模态全家桶”的终极形态——把 VL(视觉)、Audio(音频)、视频、生成 video、屏幕共享统一到一个端点。
DeepSeek 选择不做 Omni,主要原因是工程门槛太高、研究院规模团队 ROI 不划算。Qwen 选择做 Omni,是因为:
- 阿里云 ToB 需要 frontier 多模态 SKU
- 中文场景(视频客服、智能助理、教育)对 Omni 需求强烈
- 与 Qwen-VL / Qwen-Audio 多年技术积累可以直接复用
这条路在 2025-09 之前一直被业界质疑”中国玩家做不动 Omni frontier”,到 Qwen3.5-Omni 在 EgoSchema / MMMU-Pro 等评测上同时压过 GPT-4o-realtime v2 与 Gemini 2.5 Live,这个质疑基本消除。
9.2 与 GPT-4o-realtime / Gemini Live 的三方格局
到 2026-04,frontier omni 模型有三家:
| 模型 | 厂商 | 延迟 | 长视频 | 开源 |
|---|---|---|---|---|
| Qwen3.5-Omni | Tongyi Lab | ~180 ms | 60 min | ❌ |
| GPT-4o-realtime v2 | OpenAI | ~150 ms | 45 min | ❌ |
| Gemini 2.5 Live | ~210 ms | 2 hour | ❌ |
三家各有侧重——OpenAI 延迟最低、Google 上下文最长、Qwen 中文 + 价格最优。这是 omni 赛道第一次形成”美中三方”的格局,与 2024-2025 的”OpenAI 一家独大”形成明显对比。
9.3 Omni 路线对 LLM 范式的影响
回看 2024-2026 整个 LLM 范式演化,Omni 主线触发了两个范式变化:
- 从”chat”到”实时多模态对话”:模型不再是”用户敲字、模型回字”的回合制,而是”用户说话、模型同步思考 + 同步说话”的连续流式。这对 inference engine、对 RoPE 设计、对训练 pipeline 都是颠覆性变化
- 从”单 endpoint”到”屏幕级 AI agent”:Qwen3.5-Omni 的 screen-share 输入 + 生成视频输出,已经接近”AI 看着你的屏幕陪你工作”这种 agent 形态——这与 Qwen-3.7-Max 的 agent-first 战略汇流
Omni 路线很可能不是终点——它是 frontier 多模态从”被动响应”走向”主动协作”的中间形态。
十、与 DeepSeek 路线的对照(系列内 callback)
到这里 Qwen 主线 4 篇通用 LLM(Qwen-1/2/2.5/3)+ 1 篇 Qwen-3.5 + 3 篇专项分支(VL/Audio/Omni)已经讲完 8 篇。本系列的核心叙事线之一是Qwen vs DeepSeek的工程哲学对照。
放到 Omni 路线看,对照尤其鲜明:
| 维度 | Qwen Omni 路线 | DeepSeek 路线 |
|---|---|---|
| 是否做 Omni | ✅ 三代演进 | ❌ 完全不做 |
| 多模态战略 | 全家桶(VL + Audio + Omni 同步) | 单点(DeepSeek-VL 一次后停) |
| Omni 投入 | 推测约 50+ 研究员 | 0 |
| 商业模式 | 阿里云 DashScope API | 闭源旗舰 API + 通用模型开源 |
| 工程哲学 | 产品级全家桶 | 研究院风格、少数 frontier |
DeepSeek 的逻辑是 “不做做不动的事”——Omni 工程门槛太高,做不到 frontier 就不做。Qwen 的逻辑是 “全场覆盖”——只要阿里云 ToB 需要,就投资源做。
两条路径都是中国大模型路线的合理解。把 Q1 序章里的判断重复一次——理解 Qwen 不能只看通用 LLM,必须把 Omni 这条线看完。Omni 是 Qwen 战略最独特、与 DeepSeek 差异最大的一条线。
十一、本篇收官 + 系列下一步
到这里 Qwen 系列已经发布 9 篇:
- 序章 Qwen 家族技术路线图
- 第 1 篇 Qwen-1 详解
- 第 2 篇 Qwen-2 详解
- 第 3 篇 Qwen-2.5 / 1M 详解(DCA 开启 1M 上下文时代)
- 第 4 篇 Qwen-3 详解(Built-in Thinking + 高稀疏 MoE)
- 第 5 篇 Qwen-3.5 详解(Hybrid Linear Attention)
- 第 6 篇 Qwen-VL 系列详解(四代跃迁)
- 第 7 篇 Qwen-Audio 系列详解(30+ 任务)
- 第 8 篇 Qwen2.5-Omni 详解(Thinker-Talker + TMRoPE)
- 第 9 篇 Qwen3-Omni → Qwen3.5-Omni 详解(本篇)
接下来 6 篇会按以下顺序展开:
- 第 10 篇:Qwen-Coder 系列(CodeQwen 1.5 → Qwen2.5-Coder → Qwen3-Coder 480B)
- 第 11 篇:Qwen2.5-Math 详解(数学推理路线)
- 第 12 篇:QwQ 系列(QwQ-32B-Preview → QwQ-Max reasoning specialist)
- 第 13 篇:Qwen 工业落地与生态(LLaMA-Factory、SwiftFinetuning、vLLM 集成)
- 第 14 篇:Qwen vs DeepSeek vs LLaMA 三方对决收官篇
- 第 15 篇:Qwen 未来路线展望(Qwen-4 / agent / world model 推测)
下一篇见。
本系列所有文章会陆续发布在 yudonglee.me。Qwen 论文专题系列序章见 Qwen 家族技术路线图;与之对照的 DeepSeek 18 篇专题系列见 DeepSeek 技术路线图。

发表回复