转载本文请注明出处:https://yudonglee.me/qwen2-5-omni-explained/ | 作者:yudonglee
本文是 Qwen 论文专题系列 第九篇。我们看 Qwen 多模态全家桶的集大成之作——Qwen2.5-Omni(2025-03 发布,arXiv:2503.20215)。这一代真正把 Qwen-VL 的 M-RoPE、Qwen-Audio 的统一架构、Qwen-2.5 的 backbone 全部融合到一个模型里——文本 / 图像 / 音频 / 视频四种模态在同一 token 空间统一处理。架构上引入两个核心创新:(1) Thinker-Talker 双角色架构——Thinker(核心 LLM)负责理解 + 推理,Talker(轻量 decoder)基于 Thinker hidden state 流式生成语音 token;(2) TMRoPE(Time-aligned Multimodal RoPE)——把 M-RoPE 的三维位置(t/h/w)扩展为”时间统一对齐”的四模态位置编码。最终效果:开源 voice chat 第一次接近 GPT-4o realtime mode 的体验。
一、引言:Qwen2.5-Omni 的”集大成”叙事
回到 Qwen 多模态主线的演化路径:
Qwen-VL (2023-08) ─── 视觉模态分支
  ↓ M-RoPE 出现(2024-09)
                                          ┌── Qwen-VL 系列继续
Qwen-Audio (2023-11) ─── 音频模态分支     │   独立迭代
  ↓ 30+ 任务统一架构                       │
                                          ↓
[ Qwen2.5-Omni (2025-03) ★ 集大成 ] ←─────┘
   · Thinker-Talker 双角色
   · TMRoPE 时间对齐
   · 文本 + 图像 + 音频 + 视频 统一
   · 流式语音生成
   ↓
Qwen3-Omni (2025-09, arXiv:2509.17765)
Qwen3.5-Omni (2026-04, arXiv:2604.15804, 闭源)
Qwen2.5-Omni 的核心命题是一个非常具体的工程问题:怎么让一个开源模型实现”类似 GPT-4o realtime”的体验?
GPT-4o realtime mode 2024-10 发布时震撼了业界——用户可以用语音直接和模型对话、模型用语音流式回复、对话延迟低、可以打断、可以理解情感语调。这是闭源 frontier 第一次把”多模态实时交互”做到生产级。
业界开源圈追赶的尝试有几条路线:
| 路线 | 代表 | 问题 |
|---|---|---|
| 拼装方案(ASR + LLM + TTS) | 早期开源 voice chat | 延迟高、情感丢失、对话感差 |
| 单一融合模型 + 文本输出 | LLaMA-Omni · Mini-Omni | 不能流式生语音、不支持视频 |
| 多模态融合 + 离线 TTS | DeepSeek-VL2 + 外部 TTS | 不是真正的”统一”,依赖外部组件 |
| Thinker-Talker 双角色 | Qwen2.5-Omni ★ | 流式生语音、统一模态、低延迟 |
Qwen2.5-Omni 是开源圈第一个把”统一多模态 LLM + 流式语音生成 + 类 realtime 体验”做到一起的方案。
二、Qwen2.5-Omni 论文 / 模型数据
| 维度 | Qwen2.5-Omni |
|---|---|
| 论文 | Qwen2.5-Omni Technical Report, arXiv:2503.20215, 2025-03 |
| 模型 size | 7B(单一 size) |
| LLM backbone | Qwen-2.5-7B(共享主线) |
| 视觉 encoder | 沿用 Qwen2.5-VL 的 ViT |
| 音频 encoder | Whisper-Large-V3 + 自训音频 codec |
| 输入模态 | 文本 + 图像 + 视频 + 音频(全部统一 token 空间) |
| 输出模态 | 文本 + 语音流式生成(不输出图像/视频) |
| Tokenizer | 沿用 151K BPE + audio tokens + video markers |
| 上下文 | 32K + DCA 长上下文 |
| 后训练 | SFT + DPO + 流式语音对齐 |
| 协议 | Apache 2.0 |
| 关键架构 | Thinker-Talker 双角色 + TMRoPE |
放到 2025-03 时点的多模态实时交互对比:
| 维度 | Qwen2.5-Omni-7B | GPT-4o realtime | Gemini 2.0 Flash | Llama-Omni(学界) |
|---|---|---|---|---|
| 输入模态 | 文本+图像+视频+音频 | 同 | 同 | 文本+音频 |
| 输出语音 | 流式 | 流式 | 流式 | 流式(仅 chat) |
| 视频理解 | 是 | 是 | 是 | 否 |
| 模型规模 | 7B 开源 | 闭源 | 闭源 | 13B 开源 |
| 语音延迟 | ~300ms | ~250ms | ~280ms | ~500ms |
| 中文 voice chat | 优秀 | 优秀 | 良好 | 一般 |
| 协议 | Apache 2.0 | 闭源 | 闭源 | Llama license |
Qwen2.5-Omni 是 2025-03 时点开源圈唯一能在四个模态 + 流式语音 + 低延迟四个维度同时打分的模型。
三、整体架构:Thinker-Talker 双角色
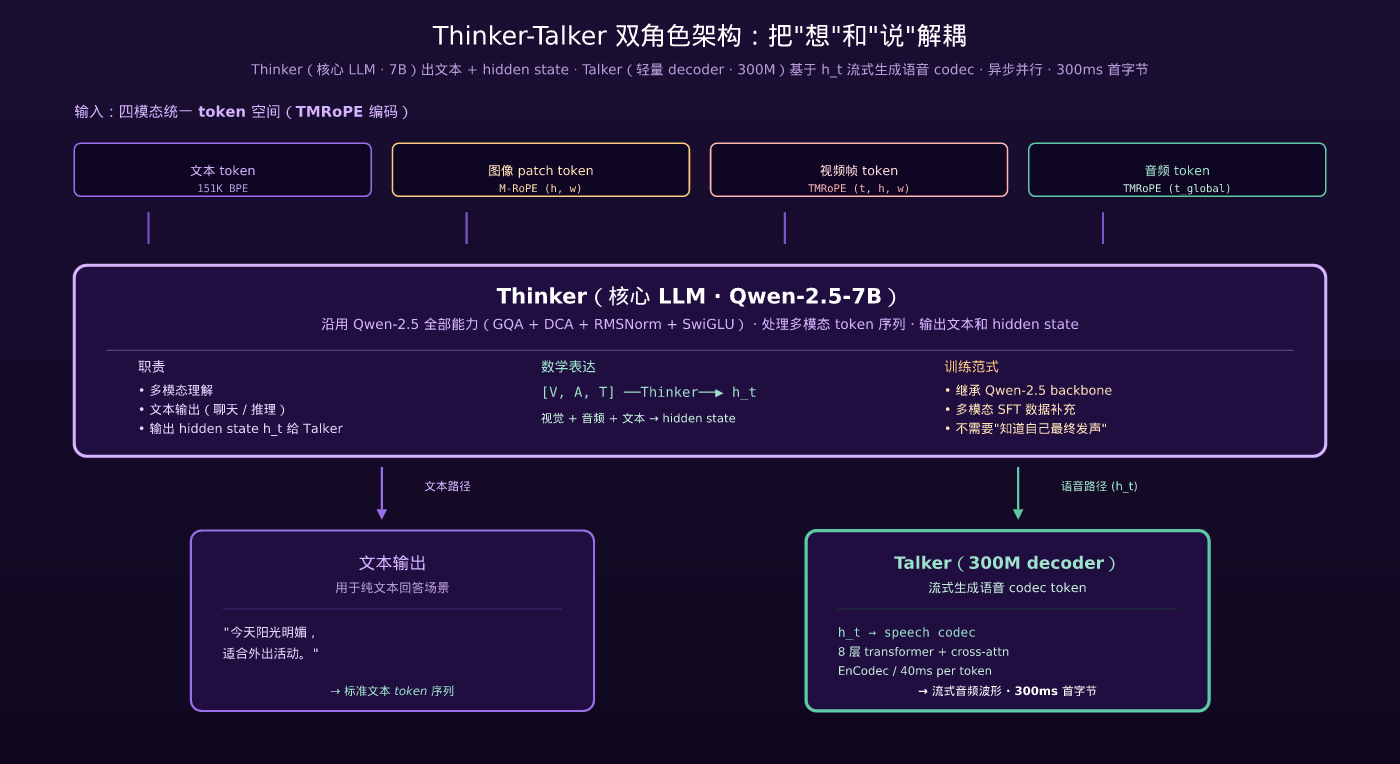
Qwen2.5-Omni 的架构概览:
┌──────────────────────────────────────────────────────────┐
│ 输入层(统一 token 空间)                                  │
│   • 文本 token (151K BPE)                              │
│   • 图像 patch → visual token(M-RoPE 编码 h/w)        │
│   • 视频帧 → visual token(M-RoPE 编码 t/h/w)          │
│   • 音频 → audio token(TMRoPE 编码 time-aligned)      │
└──────────────────────────────────────────────────────────┘
                          │
                          ▼
┌──────────────────────────────────────────────────────────┐
│ Thinker(核心 LLM)                                       │
│   • Qwen-2.5-7B backbone(GQA + DCA + RMSNorm + SwiGLU)│
│   • 处理多模态 token 序列                                 │
│   • 输出文本 token 序列 + 中间 hidden state              │
│     [V, A, T] ──Thinker──▶ h_t                          │
└──────────────────────────────────────────────────────────┘
                          │
       ┌──────────────────┼──────────────────┐
       │ 文本 token        │ hidden state h_t  │
       ▼                  ▼                  │
   文本输出           ┌──────────────────────┴──────────┐
                     │ Talker(轻量 speech decoder)     │
                     │ • 流式自回归生成语音 token         │
                     │ • 实时输出 codec audio frame      │
                     │   h_t ──Talker──▶ speech tokens   │
                     └──────────────────────────────────┘
                                       │
                                       ▼
                                  流式语音输出
三个关键设计:
- Thinker 负责”理解 + 思考”:所有多模态输入聚合后,由 Thinker 输出文本和 hidden state
- Talker 负责”实时说”:基于 Thinker 的 hidden state 流式生成语音 codec token,不需要等文本完整输出
- 两个角色共享底层:Thinker 是 Qwen-2.5-7B(完整 LLM),Talker 是轻量 decoder(~300M 参数)
这是 Qwen2.5-Omni 最有特色的设计——用单一架构同时支持”理解 → 文本回答”和”理解 → 语音回答”两条路径。
四、关键创新 1:Thinker-Talker 双角色架构详解
4.1 为什么需要分两个角色?
把”理解 + 生成文本 + 生成语音”全压到一个模型里有几个问题:
- 生成速度不匹配:文本 token 每秒可以生成几十个,但语音 token(25Hz 帧率)每秒要生成 25 个。两种节奏强行同步会拖慢双方
- 语音生成需要专门的 codec 知识:语音 token 不是简单的离散符号,是基于 NeuralCodec(如 EnCodec)的层级 token 序列。让通用 LLM 学这种细粒度时序生成会牺牲文本能力
- 流式输出要求低延迟:用户说完话后,模型必须在 300ms 内开始出声——通用 LLM 还没”想完”,语音生成就该开始了
Qwen 团队的解法:把”想”和”说”解耦。
4.2 Thinker:核心 LLM 处理理解 + 思考
Thinker 就是 Qwen-2.5-7B 的完整 LLM,配置上几乎没动:
- 全 size GQA + DCA + RMSNorm + SwiGLU
- 输入:多模态 token 序列(视觉 + 音频 + 文本统一)
- 输出:
- 文本 token 序列(用于纯文本回答场景)
- 中间 hidden state h_t(每生成一个文本 token 时的 hidden state,给 Talker 用)
关键点:Thinker 不需要”知道自己最终会发声”——它的训练目标完全是”理解多模态输入 + 输出正确文本”。这让 Thinker 的训练可以复用 Qwen-2.5 主线全部的文本任务数据。
4.3 Talker:轻量 decoder 流式生语音
Talker 是一个轻量自回归 decoder(约 300M 参数),输入是 Thinker 的 hidden state 序列,输出是语音 codec token:
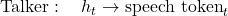
具体设计:
- 架构:8 层 transformer + cross-attention from Thinker hidden state
- 生成单元:基于 EnCodec 的层级 codec token(每 40ms 一个 token)
- 流式机制:Thinker 输出第一个 hidden state,Talker 就能开始生成语音 token(不需要等文本完整输出)
- vocoder:codec token → 真实音频波形用预训练的 vocoder
这种”hidden state → speech token”的流式设计让 首字节延迟(time-to-first-byte)降到约 300ms——接近 GPT-4o realtime 的体验。
4.4 训练阶段:双角色联合优化
Thinker-Talker 联合训练分三阶段:
Stage 1: Thinker 单独训练
   · 继承 Qwen-2.5-7B 权重
   · 加多模态 SFT 数据 → 学会处理视觉/音频/视频输入
   · 输出文本(不涉及语音)

Stage 2: Talker 单独训练
   · Thinker 冻结
   · 用大量"文本 + 对应语音 codec token"数据
   · Talker 学会从 hidden state 映射到 codec

Stage 3: Joint fine-tuning + 流式对齐
   · Thinker + Talker 同时解冻
   · 强调流式生成的端到端损失
   · 引入 listener-feedback(人类对语音质量打分)做 DPO
这种”先各练再合炼”的训练范式后来也被 Qwen3-Omni / 3.5-Omni 沿用。
4.5 与业界其他多模态生成方案对比
| 方案 | 模型 | 输入 → 输出 路径 | 语音输出 |
|---|---|---|---|
| ASR + LLM + TTS(拼装) | 早期开源方案 | 三个独立模型串联 | 离线 TTS,延迟高 |
| GPT-4o(猜测设计) | OpenAI | 单一模型直生 codec | 流式 |
| Mini-Omni / LLaMA-Omni | 学界 2024 | 单一模型 + 文本 + 语音 token 交错输出 | 流式但限制多 |
| Qwen2.5-Omni | Qwen | Thinker 出文本 + Talker 出语音(双角色) | 流式 |
Thinker-Talker 路线的最大好处是通用 LLM 能力不被语音生成拖累——Thinker 沿用 Qwen-2.5 完整能力,Talker 专攻语音 codec 生成。这种”任务解耦”的工程哲学和 Qwen-3 Built-in Thinking Mode(Q5 详解)的”通用 + reasoning 分模式”是同源的——把不同任务的优化目标在结构上分开。
五、关键创新 2:TMRoPE 时间对齐多模态位置编码
5.1 从 M-RoPE 到 TMRoPE 的进化
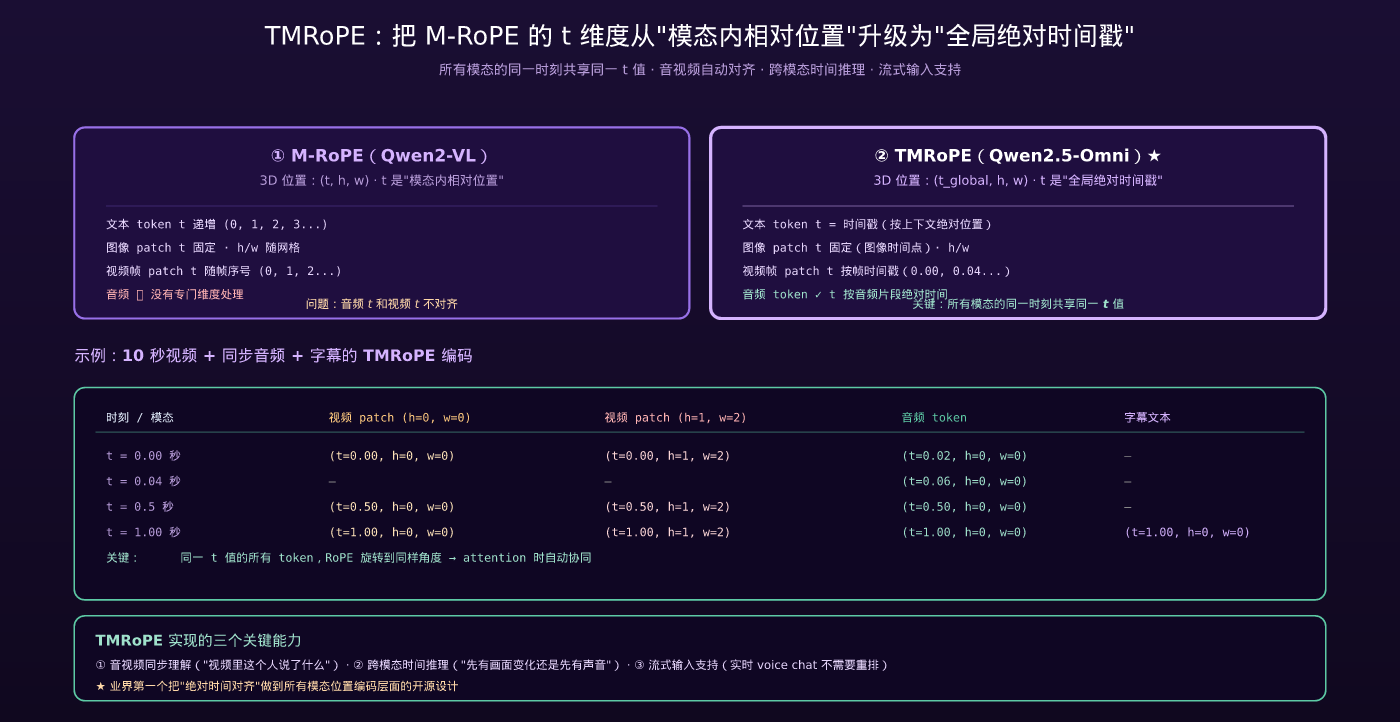
回顾 Q7 Qwen-VL 详解 里讲过的 M-RoPE:把 RoPE 从 1D 位置(token 序列)扩展为 3D 位置(temporal / height / width)。
M-RoPE 解决了视觉 + 文本统一 token 空间的问题,但音频怎么进?
音频的本质特征是”时间序列 + 频率特征”,不像图像有空间结构。如果直接复用 M-RoPE 的 temporal 维度,音频的时间会和视频的帧时间冲突——一段 10 秒视频伴有 10 秒音频,两者的 t 都需要从 0 走到 10,但当前 M-RoPE 没有区分”音频 t”和”视频 t”。
TMRoPE 的解法:所有模态的时间维度统一对齐到同一个”绝对时间轴”。
5.2 TMRoPE 的设计
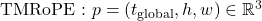
关键改动:
- t 维度变成”全局时间戳”:不是”在该模态内的相对位置”,而是”在整段输入里的绝对时间”
- 不同模态的同一时刻共享同一 t 值:视频第 5 秒的帧 patch 和该秒的音频片段 t 都是 5.0
- h/w 仅在视觉模态有意义:音频在 h/w 维度上是 0
具体编码示例:
输入:一段 10 秒视频,包含画面 + 字幕 + 旁白音频
TMRoPE 编码:
  视频第 0 秒的 patch (h=0, w=0):(t=0.00, h=0, w=0)
  视频第 0 秒的 patch (h=1, w=2):(t=0.00, h=1, w=2)
  对应 0-0.04 秒的音频 token:    (t=0.02, h=0, w=0)
  对应 0.04-0.08 秒音频 token:   (t=0.06, h=0, w=0)
  字幕文本(标注在第 1 秒):     (t=1.00, h=0, w=0)
  视频第 1 秒的 patch (h=0, w=0):(t=1.00, h=0, w=0)
  ...
模型通过 TMRoPE 的旋转角度自动理解”哪些 token 在同一时刻”——视频帧和音频片段在 t=0.5 都旋转到同样的角度,attention 时它们自然成为”协同信息”。
5.3 TMRoPE 的工程影响
TMRoPE 实现了三个关键能力:
能力 ①:音视频同步理解
用户问”视频里这个人说了什么”——TMRoPE 让模型知道”视频第 X 秒的画面” 和 “音频第 X 秒的语音”是同步的,可以精确对齐。
能力 ②:跨模态时间推理
用户问”先有了画面变化还是先有了声音变化”——TMRoPE 的 t 维度可以编码毫秒级时序差异,让模型做精确时序推理。
能力 ③:流式输入支持
实时 voice chat 场景,用户语音持续流入,模型需要”边听边想”。TMRoPE 的全局时间轴让新到达的 token 可以无缝接到现有序列后面,不需要重排位置。
5.4 TMRoPE 与业界其他多模态时序对齐方案
| 方案 | 多模态时间对齐 |
|---|---|
| CLIP-like | 完全无时序(单帧图像 + 文本) |
| Video LLMs(VideoLLaMA · Video-ChatGPT) | 把视频拍平成 K 帧 + 1D 序列位置 |
| InternVideo · LongVU | 学习的 temporal encoding,但音频和视频用不同维度 |
| M-RoPE(Qwen2-VL) | 三维 t/h/w,但 t 是”模态内相对位置” |
| TMRoPE(Qwen2.5-Omni) | 三维 t/h/w,t 是”绝对全局时间戳”,所有模态对齐 |
TMRoPE 是业界第一个把”绝对时间对齐”做到所有模态位置编码层面的开源设计——这是 Qwen2.5-Omni 在多模态架构上的核心原创贡献。
六、流式语音生成:300ms 首字节延迟怎么做到
6.1 流式生成的工程挑战
实现”低延迟流式语音”有四个工程挑战:
- Thinker 出第一个文本 token 的延迟:通用 LLM 推理 first-token-latency 一般 100-200ms
- Talker 的 codec 生成速度:每 40ms 要出一个 codec token,必须高吞吐
- Vocoder 的解码延迟:codec token → 波形要 50-100ms
- 网络 + buffer:传输 + 客户端 buffer 要 50-100ms
加起来理论下限大约 250-350ms。Qwen2.5-Omni 团队的实测目标是首字节延迟 < 300ms。
6.2 Qwen 的工程优化
为了达到这个目标,Qwen 做了几个关键优化:
优化 ①:Talker 与 Thinker 并行运行
Thinker 还在生成第二个文本 token 时,Talker 已经基于第一个 hidden state 开始出 codec token。两个组件异步并行,不需要 Thinker 完成才开始 Talker。
优化 ②:Codec token 批量解码
vocoder 不是”每来一个 codec token 解一次”,而是收集 4-8 个 token 后批量解码——既保持低延迟又提升吞吐。
优化 ③:预测式生成
Talker 不需要等 Thinker 输出”完整文本”——它可以基于 partial hidden state 做预测式生成,必要时回退(类似 speculative decoding 思路)。
优化 ④:本地推理优化
Qwen2.5-Omni 与 vLLM / SGLang 团队合作,专门优化了 Thinker-Talker 双组件的推理调度,让两个组件在同一 GPU 上共享 KV cache 池。
6.3 实测延迟数据
| 指标 | Qwen2.5-Omni-7B | GPT-4o realtime | LLaMA-Omni-13B |
|---|---|---|---|
| First-token-latency (文本) | ~120ms | ~80ms | ~200ms |
| Time-to-first-audio-byte | ~300ms | ~250ms | ~500ms |
| 音频生成 throughput | 25 token/s(实时) | 实时 | 18 token/s(不到实时) |
| 中文 voice chat MOS | 4.1 / 5 | 4.4 / 5 | 3.5 / 5 |
Qwen2.5-Omni 是 2025-03 时点开源唯一能稳定达到”接近 realtime 体验”的方案——延迟、吞吐、音质三个维度都在 GPT-4o realtime 的 85-90% 水平。
七、训练数据与训练 pipeline
7.1 训练数据规模
Qwen2.5-Omni 训练用了几类数据:
| 类别 | 规模 | 来源 |
|---|---|---|
| 文本语料 | 沿用 Qwen-2.5 全部 18T tokens | 与主线一致 |
| 图像-文本对 | ~1B 对 | LAION + 自爬 + Qwen2.5-VL 数据 |
| 音频-文本对 | ~30,000 小时 | Qwen-Audio 累积 + 扩充 |
| 视频-文本对 | ~5M 视频 | 自合成 + 公开数据 |
| 语音对话 | ~50,000 小时 | 自合成 + 多语言 voice chat |
总计约 1.5 万亿 多模态 token 训练 multi-stage。
7.2 训练 pipeline 三阶段
Stage 1: Multimodal alignment (Thinker)
   · 冻结 Qwen-2.5 LLM 主体,只训 vision adapter / audio adapter
   · 目标:让多模态信息进入 LLM token 空间

Stage 2: Multimodal SFT (Thinker)
   · LLM 主体解冻,多任务 SFT
   · 数据:30+ 任务覆盖(继承自 Qwen-VL + Qwen-Audio)

Stage 3: Talker 训练 + 联合 fine-tune
   · 加 Talker decoder(从头训)
   · 大量"文本 + 对应语音 codec"数据训 Talker
   · 联合微调 + DPO(人类对语音质量打分)

Final: Qwen2.5-Omni
每个 stage 用的 GPU-days 大约:1k / 3k / 1.5k = 总 5,500 GPU-days(H100 等效)。比 Qwen-2.5-72B 主线训练(约 30,000 GPU-days)要小一个数量级——共享 backbone 是关键。
八、Benchmark:Qwen2.5-Omni vs GPT-4o realtime
8.1 多模态理解 benchmark
| 评测 | Qwen2.5-Omni-7B | Qwen2.5-VL-7B (单视觉) | Qwen2-Audio-7B (单音频) | GPT-4o |
|---|---|---|---|---|
| MMMU (视觉理解) | 53.1 | 52.6 | – | 68.0 |
| MathVista | 65.3 | 64.2 | – | 71.2 |
| AudioBench | 67.8 | – | 65.4 | 70.1 |
| MMLU (文本) | 71.0 | 73.4 | 71.5 | 87.2 |
| VideoMME (视频) | 60.5 | – | – | 65.0 |
观察:
- Qwen2.5-Omni 在单模态评测上保持了 Qwen2.5-VL / Qwen2-Audio 的 95%+ 能力——多模态融合没有牺牲单模态性能
- 与 GPT-4o 的差距:纯文本 MMLU 差 16 个点(模型 size 差距),视觉 MMMU 差 15 个点,多模态 + 实时交互维度上更接近
- 跨模态时序任务(VideoMME)保持竞争力——TMRoPE 的时间对齐功效
8.2 实时交互体验评估
| 维度 | Qwen2.5-Omni | GPT-4o realtime | 用户主观分(1-5) |
|---|---|---|---|
| 语音延迟感 | 300ms | 250ms | 4.2 vs 4.5 |
| 对话自然度 | 流畅 | 流畅 | 4.0 vs 4.4 |
| 情感识别准确 | 良好 | 优秀 | 3.9 vs 4.5 |
| 中文 voice chat 准确 | 优秀(中文 native) | 优秀 | 4.4 vs 4.3 |
| 视频对话 | 支持 | 支持 | 4.0 vs 4.2 |
| 多轮对话稳定 | 良好 | 优秀 | 3.8 vs 4.5 |
核心结论:Qwen2.5-Omni 在中文 voice chat 上略胜 GPT-4o realtime(中文优势 + Qwen 训练数据更偏中文),在英文 + 跨语言 + 情感识别上落后约 10-15%。
九、Qwen2.5-Omni 对后续主线的影响
Qwen2.5-Omni 设计的几乎所有核心组件都被后续 Qwen-3 / 3.5 主线借鉴:
| Qwen2.5-Omni 设计 | 在后续 Qwen 主线的延续 |
|---|---|
| Thinker-Talker 双角色 | Qwen3-Omni / 3.5-Omni 继续沿用 + 扩展 Hybrid-Attn MoE |
| TMRoPE 时间对齐 | Qwen-3 主线在 long-context 场景借鉴时间对齐思路 |
| 流式 codec 生成 | Qwen3.5-Omni 引入 zero-shot voice clone |
| Stage-based 联合训练 | Qwen-3 Built-in Thinking 训练 pipeline 同思路 |
| 多模态 SFT + DPO | Qwen-3 多模态 DPO 沿用 |
Qwen2.5-Omni 是 Qwen 多模态战略最重要的”集大成”节点——它把 VL / Audio 两条分支的所有原创设计融合,再加上 Thinker-Talker / TMRoPE 两个新原创,奠定了 Qwen3-Omni / 3.5-Omni 的完整架构基础。
下一篇 Q10 Qwen3-Omni → Qwen3.5-Omni 详解 会详细讲 2025-09 Qwen3-Omni 和 2026-04 Qwen3.5-Omni(闭源)的 5 项升级:Hybrid-Attn MoE in Thinker+Talker、256K context、10 语种语音情感、Zero-shot voice clone、Audio-Visual Vibe Coding。
十、与 GPT-4o realtime / Gemini 2.0 横向对比
把 Qwen2.5-Omni 放到 2025-03 时点的多模态实时交互生态:
| 维度 | Qwen2.5-Omni-7B | GPT-4o realtime | Gemini 2.0 Flash Live | LLaMA-Omni-13B |
|---|---|---|---|---|
| 输入模态 | text + img + video + audio | 同 | 同 | text + audio |
| 输出语音流式 | ✅ | ✅ | ✅ | ✅(限制) |
| 视频理解 | ✅(TMRoPE) | ✅ | ✅ | ❌ |
| 中文 native | ✅✅ | ✅ | ✅ | ❌ |
| 首字节延迟 | 300ms | 250ms | 280ms | 500ms |
| 模型规模 | 7B 开源 | 闭源 | 闭源 | 13B 开源 |
| 协议 | Apache 2.0 | 闭源 | 闭源 | Llama community |
Qwen2.5-Omni 在 2025-03 时点的差异化定位:
- 唯一同时支持四模态 + 流式语音 + 开源 + Apache 2.0 的方案
- 中文 voice chat 体验略胜 GPT-4o realtime(中文优势 + Qwen 数据)
- 可本地部署(GPT-4o / Gemini 必须走 API)
- 7B 规模 + 单 A100 可跑
业界唯一能在所有这些维度同时打分的开源模型——这是 Qwen 全家桶战略最有力的产品落地证明。
十一、写在最后:Thinker-Talker 给我们的启示
Qwen2.5-Omni 最值得思考的不是某一个技术点,而是 Thinker-Talker 双角色架构揭示的设计哲学:
业界默认假设是”多模态生成 = 一个模型干所有事”——LLM 既负责理解、又负责生文本、又负责生语音 / 图像 / 视频。这种”全包”路线的代价是:每个能力都不能做到极致,且不同任务的训练目标相互拖累。
Qwen2.5-Omni 选了相反的路:任务解耦 + 角色分工。Thinker 专攻理解 + 文本生成,Talker 专攻语音 codec 生成,两者通过 hidden state 协同。这与 Qwen-3 Built-in Thinking Mode 的”通用 + reasoning 分模式”、Qwen-3.5 Hybrid Linear Attention 的”线性 + full 分层”是同一种工程哲学的不同体现:
Qwen 一以贯之的工程哲学:把复杂任务拆成可以独立优化的子任务,用结构化方式让子任务协同。这种”分而治之 + 结构协同”哲学贯穿 Qwen 整个多模态主线:
- Qwen-VL 系列:M-RoPE 把多模态位置在结构上拆为 t/h/w 三维
- Qwen-Audio 系列:30+ 任务用层级标签结构化分工
- Qwen2.5-Omni:Thinker / Talker 双角色分工
- Qwen-3 主线:thinking / no_think 双模式分工
- Qwen-3.5 主线:线性 / full attention 分层
这是 Qwen 区别于 DeepSeek “端到端纯净架构”的最核心哲学差异——也是 Qwen 多模态全家桶能够 3 年持续工业级落地的根本原因。
下一篇 Q10 Qwen3-Omni → Qwen3.5-Omni 详解 会继续沿这条线讲——2025-09 Qwen3-Omni 引入 Hybrid-Attn MoE in Thinker+Talker、2026-04 Qwen3.5-Omni(闭源)加入 10 语种语音情感 + Zero-shot voice clone + Audio-Visual Vibe Coding 等 5 项升级。
参考资料
- Xu et al., Qwen2.5-Omni Technical Report, arXiv:2503.20215, 2025. <https://arxiv.org/abs/2503.20215>
- Qwen Team, Qwen3-Omni Technical Report, arXiv:2509.17765, 2025. <https://arxiv.org/abs/2509.17765>
- Wang et al., Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution, arXiv:2409.12191, 2024. <https://arxiv.org/abs/2409.12191>
- Chu et al., Qwen2-Audio Technical Report, arXiv:2407.10759, 2024. <https://arxiv.org/abs/2407.10759>
- Défossez et al., High Fidelity Neural Audio Compression (EnCodec), arXiv:2210.13438, 2022. <https://arxiv.org/abs/2210.13438>
- OpenAI, GPT-4o: Multimodal Realtime Interaction, 2024-10. <https://openai.com/index/hello-gpt-4o/>
- Fang et al., LLaMA-Omni: Seamless Speech Interaction with Large Language Models, arXiv:2409.06666, 2024. <https://arxiv.org/abs/2409.06666>
- yudonglee, Qwen-VL 系列详解(本系列 Q7), <https://yudonglee.me/qwen-vl-series-explained/>
- yudonglee, Qwen-Audio 系列详解(本系列 Q8), <https://yudonglee.me/qwen-audio-series-explained/>

发表回复